Обиднее всего, что решение лежало на поверхности, мы с вами его уже видели. Вспомните компьютер: одна его команда тоже умеет очень немногое, но последовательность команд, где каждая следующая работает с результатом предыдущей, справляется с чем угодно – считает любую математику, воспроизводит любую логику. Если один шаг упирается в потолок, надо сделать много шагов. Применим ту же идею к нейронам: пусть ответ складывается не из одного «перемножить и сложить», а из цепочки таких шагов. Один шаг это умножение на матрицу, значит, ставим умножения цепочкой: вектор умножили на первую матрицу, результат – на вторую, потом на третью, и так далее.
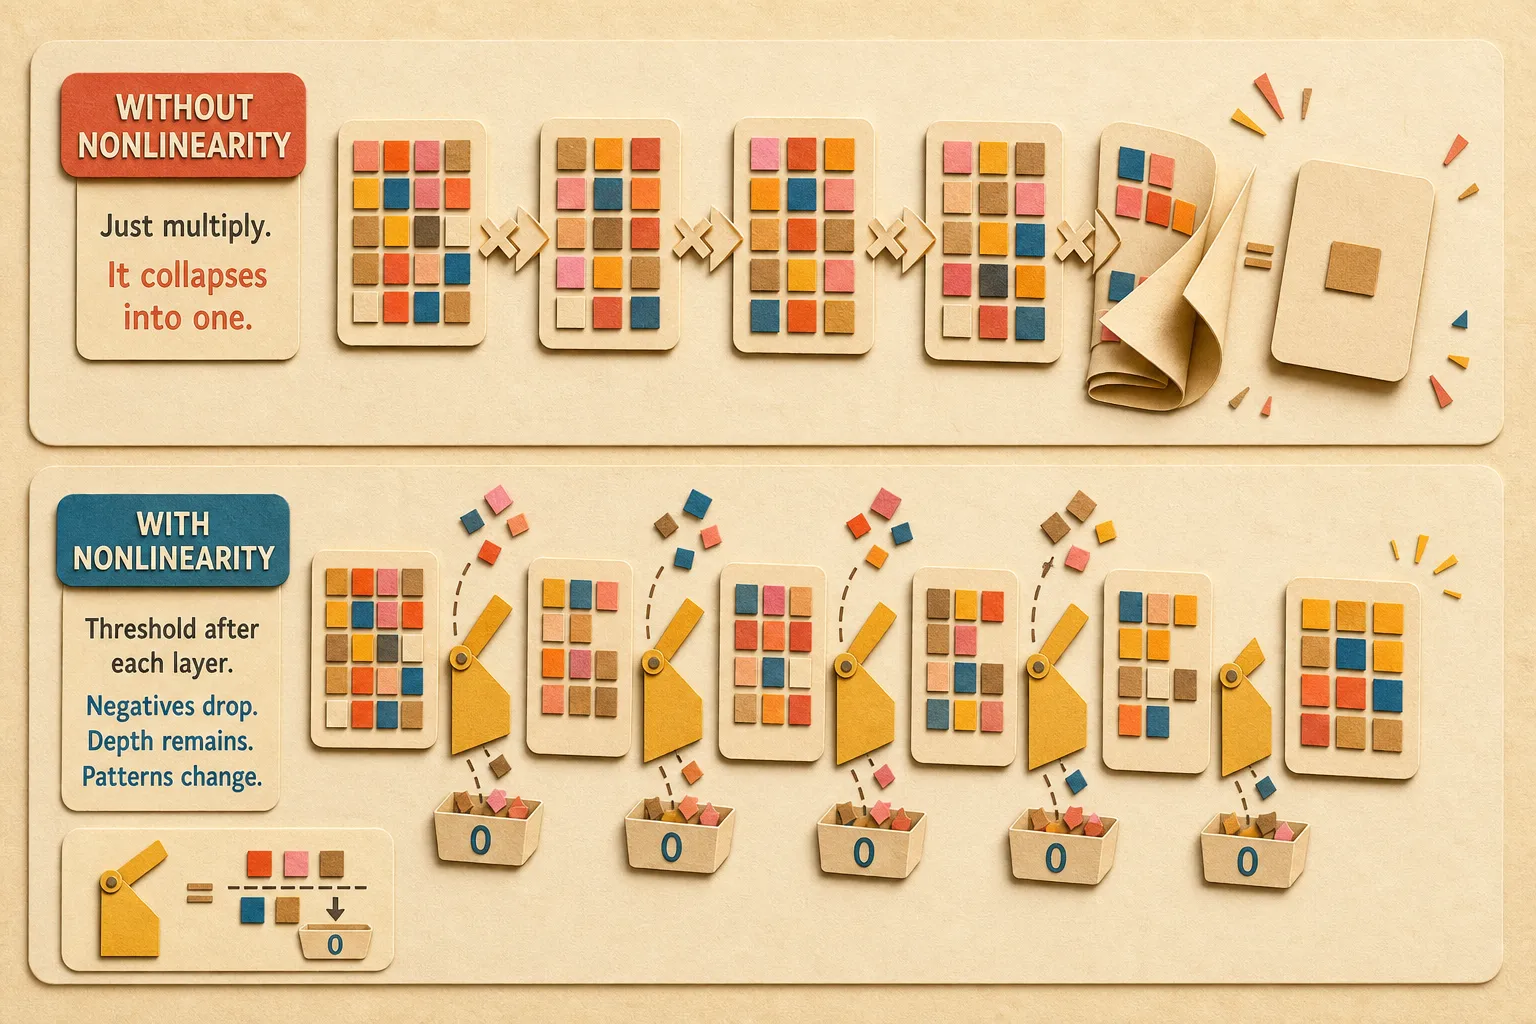
Но нельзя просто так взять и сделать множество матриц… Все матрицы известны заранее и не зависят от того, что придёт на вход. А всё, что известно заранее, можно и вычислить заранее: перемножить сто матриц между собой один раз и получить одну.
V × M₁ × M₂ × M₃ = V × (M₁ M₂ M₃) = V × M_one
Это простое упрощение убивает всю затею: цепочка из ста матриц работает в точности как одна матрица. Как сказали бы математики – Эквивалентно! Стена Минского и Пейперта никуда не делась.
Зато теперь понятно, что именно нужно: помешать цепочке схлопываться. Схлопывание работает потому, что вся цепочка состоит из одних умножений и сложений. Вставим между умножениями что-то, что через умножение и сложение не выражается, что-то нелинейное!
И такое нелинейное действие может быть до смешного маленьким. Сегодняшний стандарт – правило ReLU1: «если число отрицательное, замени его нулём». Присмотритесь: это условие, «если» – то, чего у «перемножить и сложить» не было вовсе. А вот у живого нейрона оно было всегда: тот самый порог, «вспыхнуть или молчать», и есть природная нелинейность, она стояла ещё в модели Маккалока и Питтса. Выстраивая голые умножения в цепочку, мы её потеряли – теперь просто возвращаем на место. Какие именно числа обнулятся, зависит от входных данных, а то, что зависит от входа, заранее не вычислишь. Цепочка перестаёт схлопываться, каждый шаг начинает добавлять к ответу что-то своё, и сто матриц наконец становятся сотней настоящих операций. Такая цепочка – умножения на матрицы с нелинейностями между ними – и называется нейросетью. А каждый её шаг, матрица плюс нелинейность, называется слоем.
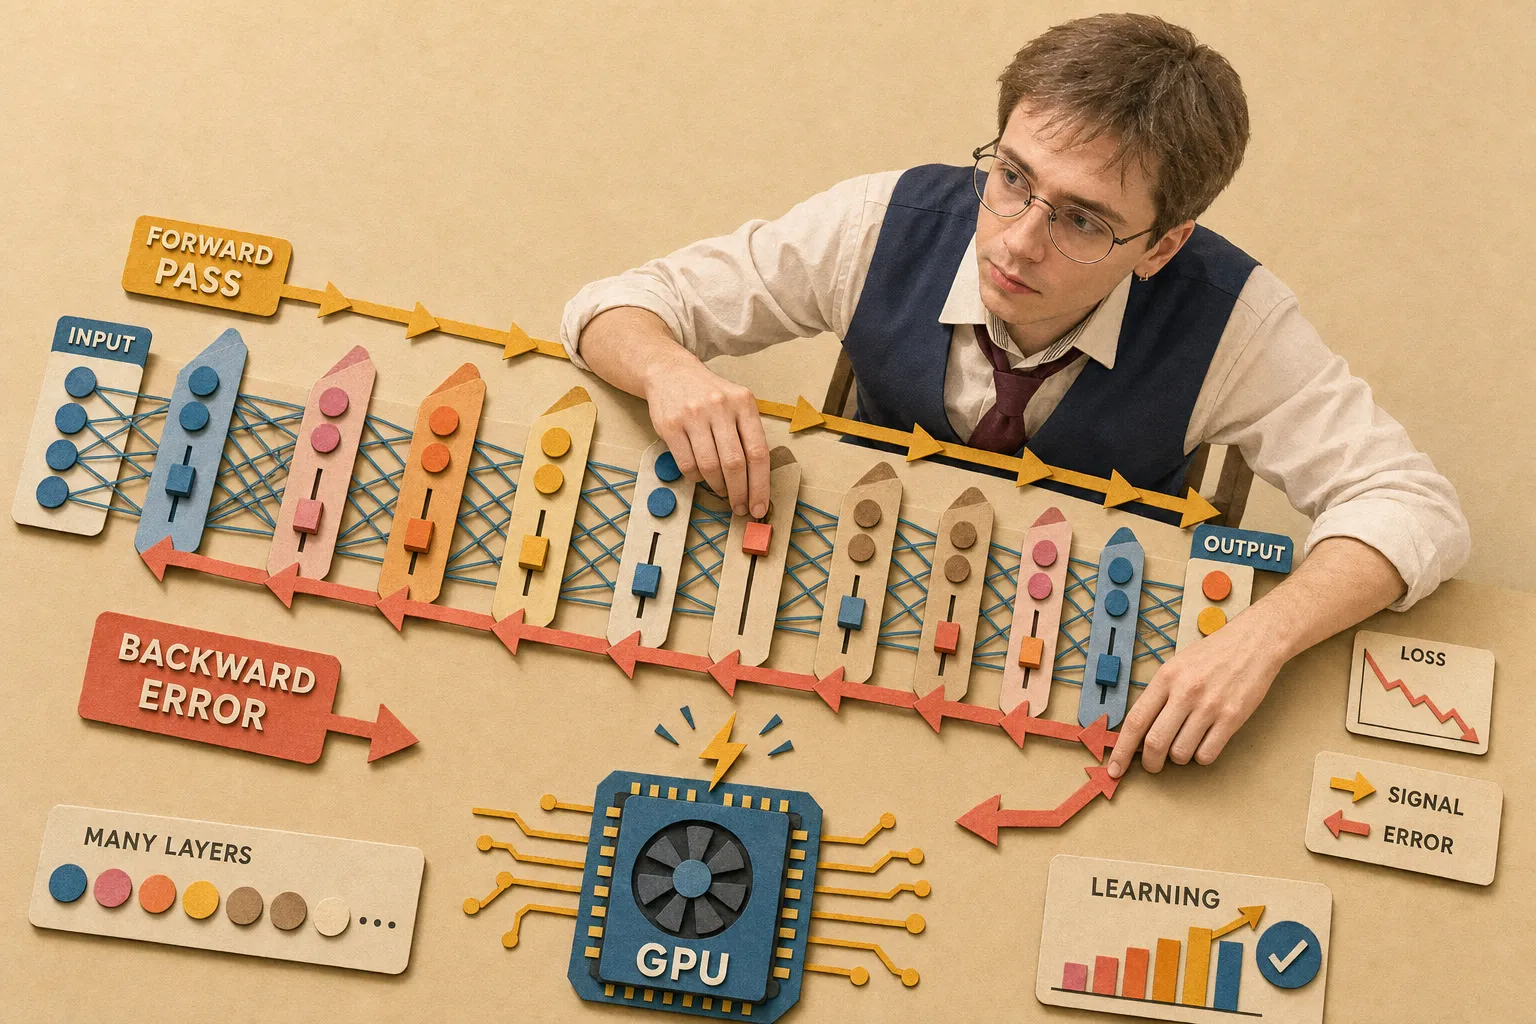
Зачем слоёв так много? Затем же, зачем программе много команд: каждый следующий слой работает с результатом предыдущего, и сложность накапливается. Первые слои собирают из букв слова, средние выделяют смыслы, поздние формируют сам ответ. Позже математики строго доказали2, что мелкой сети для той же работы понадобилось бы астрономически больше нейронов; красивее всего это показано в визуализациях 3Blue1Brown3. Одна матрица это одна формула. Сто слоёв это уже программа из ста последовательных шагов и условий. И разница между ними та же, что между калькулятором и интеллектом.
Оставался вопрос, как такую многослойную сеть учить. В 1986 году Румельхарт, Хинтон и Уильямс4 дали ответ, который используется до сих пор: ошибка на выходе прокатывается назад сквозь все слои и подправляет каждую матрицу. Метод назвали backpropagation (обратное распространение ошибки). А по-настоящему глубина заработала в 2012 году, когда сеть AlexNet5 на игровых видеокартах разгромила всех на конкурсе распознавания изображений. С этого момента слои стали считать десятками и сотнями: у GPT-36 их 96, а у Llama 3.1 405B7 уже 126. Собственно, поэтому такие сети и называют «глубокими», а всю область – deep learning.
Цепочка матриц:     голые умножения схлопываются обратно в одну матрицу
                       ↓
Нелинейность:       «если» между умножениями – и цепочка не схлопывается:
                    так матрицы становятся нейросетью из слоёв
                       ↓
Хинтон и коллеги:   ошибка учит сразу много слоёв (backpropagation)
                       ↓
ReLU и GPU:         глубина заработала, слоёв стали сотни
И вот таким образом, ровно как простых 0 и 1 достаточно, чтобы сделать всю магию компьютеров, так и простых матриц с нелинейностью между ними оказывается достаточно, чтобы создать магию Интеллекта.
Это фундамент всего, и это офигенно. Но это только начало!
Источники
-
Glorot, Bordes, Bengio, «Deep Sparse Rectifier Neural Networks», 2011 – работа, сделавшая ReLU стандартом глубоких сетей. – https://proceedings.mlr.press/v15/glorot11a/glorot11a.pdf ↩
-
Telgarsky, «Benefits of Depth in Neural Networks», 2016 – строгое доказательство преимущества глубины. – https://arxiv.org/abs/1602.04485 ↩
-
3Blue1Brown, «But what is a neural network?» – лучшая визуализация работы нейросети. – https://www.youtube.com/watch?v=aircAruvnKk ↩
-
Rumelhart, Hinton, Williams, «Learning Representations by Back-Propagating Errors», Nature, 1986 – backpropagation, метод обучения многослойных сетей. – https://www.cs.toronto.edu/~hinton/absps/naturebp.pdf ↩
-
Krizhevsky, Sutskever, Hinton, «ImageNet Classification with Deep CNNs» (AlexNet), 2012 – момент, когда глубокое обучение заработало на GPU. – https://proceedings.neurips.cc/paper_files/paper/2012/file/c399862d3b9d6b76c8436e924a68c45b-Paper.pdf ↩
-
Brown et al., «Language Models are Few-Shot Learners» (статья GPT-3), 2020. – https://arxiv.org/abs/2005.14165 ↩
-
Llama Team (Meta*), «The Llama 3 Herd of Models», 2024. – https://arxiv.org/abs/2407.21783 ↩