Дальше идею «частое – коротко» довели до автоматизма архиваторы. В 1977 году Лемпель и Зив1 предложили сжимать данные словарём: часто повторяющиеся последовательности заносим в словарь, а в тексте вместо них ставим короткую ссылку. Каждый ZIP-файл на вашем диске работает на потомках этой идеи.
Линия таблиц тем временем упёрлась в собственный потолок. В таблице Бемера 128 знаков: английские буквы, цифры, знаки препинания и служебные коды. Места для других письменностей в ней нет. Каждая страна завела свою таблицу поверх ASCII: в Японии Shift JIS, в России KOI-8 и потом Windows-1251, и у каждой свои номера для своих букв. Текст, записанный в одной таблице и открытый в другой, превращался в мусор из случайных знаков, по-японски это явление даже получило имя, 文字化け, «моджибаке», и в 1980-х его знал каждый, кто пересылал файл за границу. В 1988 году Джо Беккер из Xerox2 предложил сделать одну таблицу на все письменности мира сразу, и в 1991 году вышел Unicode. Его постепенно расширяли, добавляя знаки разных письменностей, а позднее и эмодзи. Оставался вопрос, как записывать номера из такой таблицы байтами, чтобы старые файлы в ASCII не сломались. В 1992 году Кен Томпсон и Роб Пайк3 за ужином в закусочной в Нью-Джерси набросали на салфетке UTF-8: английская буква остаётся одним байтом, как у Бемера, русская занимает два байта, многие иероглифы три. В этой кодировке сегодня хранится почти весь интернет, и она же лежит на входе у языковых моделей.
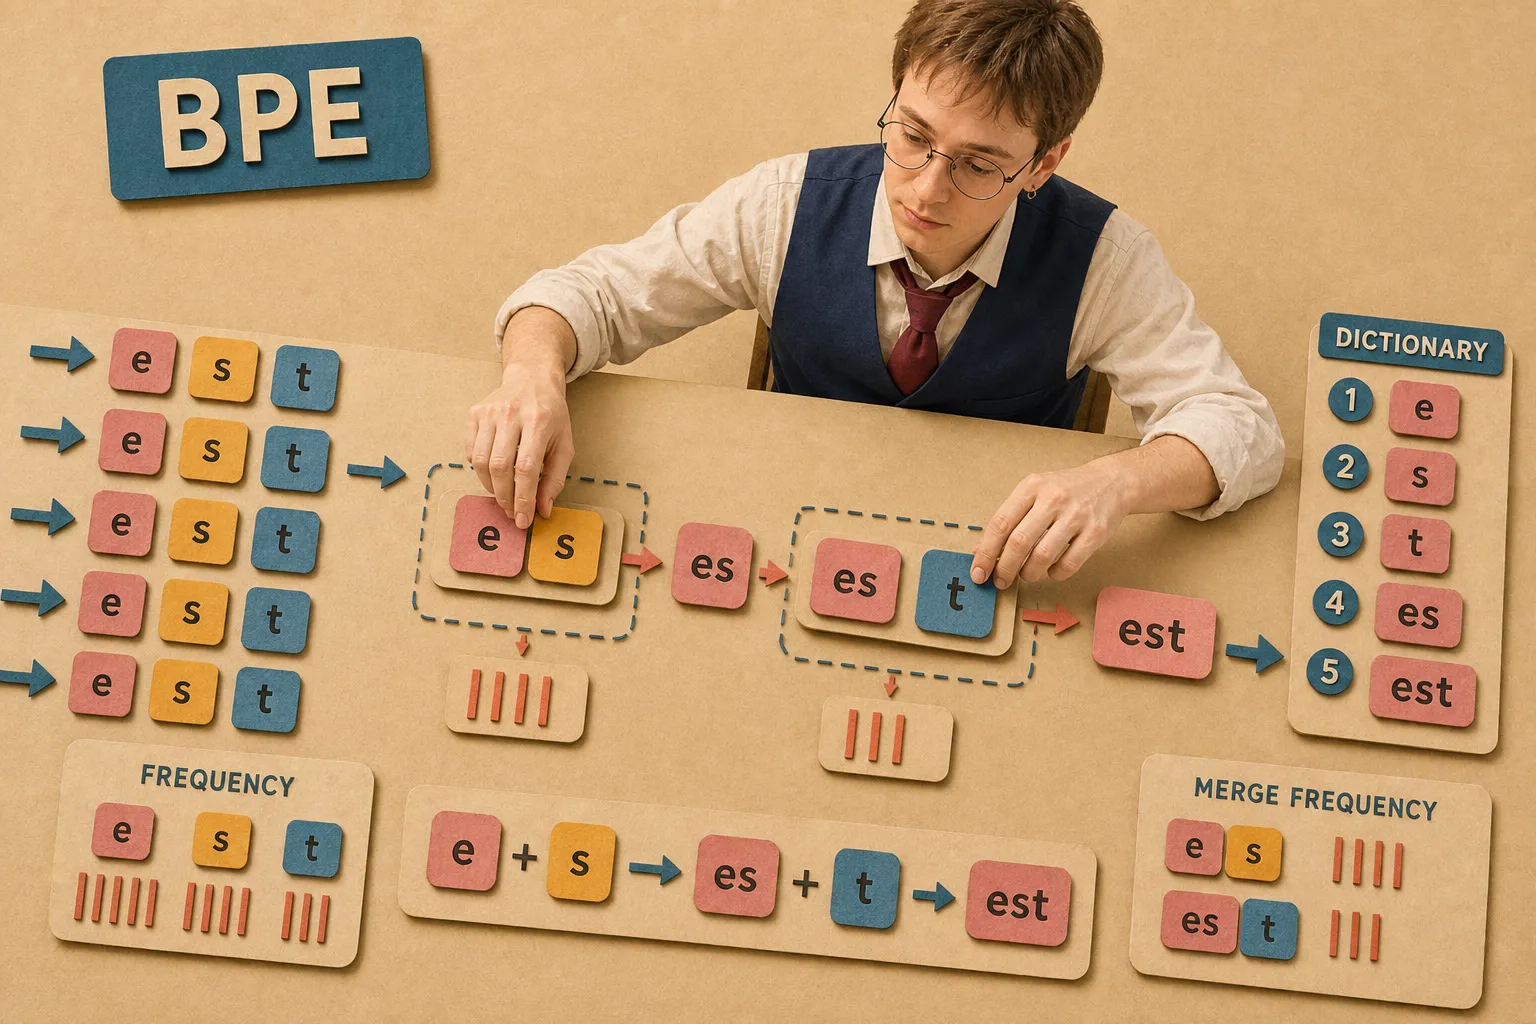
А в 1994 году Филип Гейдж4 описал совсем простой вариант сжатия словарём, byte pair encoding, сокращённо BPE: найди в данных самую частую пару соседних символов, склей её в новый символ, добавь в словарь. Повторяй, пока словарь не наберётся. На крошечном корпусе из слов low, lower, newest и widest первые шаги выглядят так:
шаг 1: самая частая пара  e + s   (9 раз)  →  новый символ  es
шаг 2: самая частая пара  es + t  (9 раз)  →  новый символ  est
шаг 3: самая частая пара  est + _ (9 раз)  →  новый символ  est_
шаг 4: самая частая пара  l + o   (7 раз)  →  новый символ  lo
Из букв сами собой вырастают суффикс «-est» и корень «lo», без единого правила грамматики. Алгоритму всё равно, что это язык: он видит только частоты.
Всё это, от Морзе до Гейджа, делалось ради экономии – телеграфных денег, места на диске. Об интеллекте никто не думал, и с матрицами было ровно так же: инструмент появился задолго до своей главной задачи.
Мостик к нейросетям перекинули в 2016 году, и причина была сугубо практическая. Нейросетевым переводчикам нужно было решить, какими кусками скармливать текст, и у каждого из двух очевидных вариантов была своя цена:
по буквам:   словарь небольшой, но последовательности длиннее –
             больше единиц приходится обрабатывать модели
по словам:   все слова заранее не перечислить: имена, опечатки, новые слова...
             слово вне словаря = «неизвестно что»
Сеннрих с коллегами5 взяли BPE, алгоритм сжатия двадцатилетней давности, и нашли золотую середину: пусть словарь соберёт себя сам, из данных. Частые слова могут целиком стать токенами, редкие собираются из знакомых кусков, вплоть до отдельных символов. Теперь ради нового слова не обязательно заводить новую строку в словаре.
Получилась таблица, как у Бодо и Бемера, каждому знаку свой номер. Только размер такой таблицы выбирают разработчики: десятки или сотни тысяч строк. А сами фрагменты отбираются по правилу Морзе и рецепту Гейджа: чем чаще последовательность встречается в подготовленных для словаря текстах, тем больше у неё шансов стать отдельным токеном со своим номером.
Оставалась ещё одна трудность: многие инструменты сначала делили текст на слова по пробелам. Но, например, японский текст так не устроен. В 2018 году Таку Кудо и Джон Ричардсон из Google6 представили SentencePiece, который учится нарезке прямо на тексте, без предварительного выделения слов. BPE стал одним из поддерживаемых им способов. Задачу можно решать разными алгоритмами, даже когда на выходе у всех получаются токены.
В 2019 году OpenAI для GPT-27 стала склеивать не буквы, а байты UTF-8: так словарь заведомо покрывает любой текст на любом языке, ведь байтов всего 256. Исходная длина записи при этом различается: английская буква начинается с одного байта, русская с двух, многие иероглифы с трёх. Сколько токенов получится в конце, зависит и от этой длины, и от выученных склеек.
Возьмём нашу фразу и словарь o200k_base:
"Which camera should I buy for a blog?"
       ↓
[ 34405, 9427, 1757, 357, 3877, 395, 261, 4109, 30 ]
Фрагмент « for», вместе с пробелом перед словом, здесь один цельный токен, номер 395. Фрагмент « camera» тоже получил свой номер, 9427. А слово, которого целиком в словаре нет, например название нового бренда, можно собрать из нескольких частей.
Увидеть это можно на tiktokenizer.vercel.app8: любой вставленный текст там крошится на цветные кусочки, и вся механика становится наглядной за минуту. А разобрать токенизатор до винтика можно вместе с Карпаты, который собирает его с нуля за два часа в Let’s build the GPT Tokenizer9.
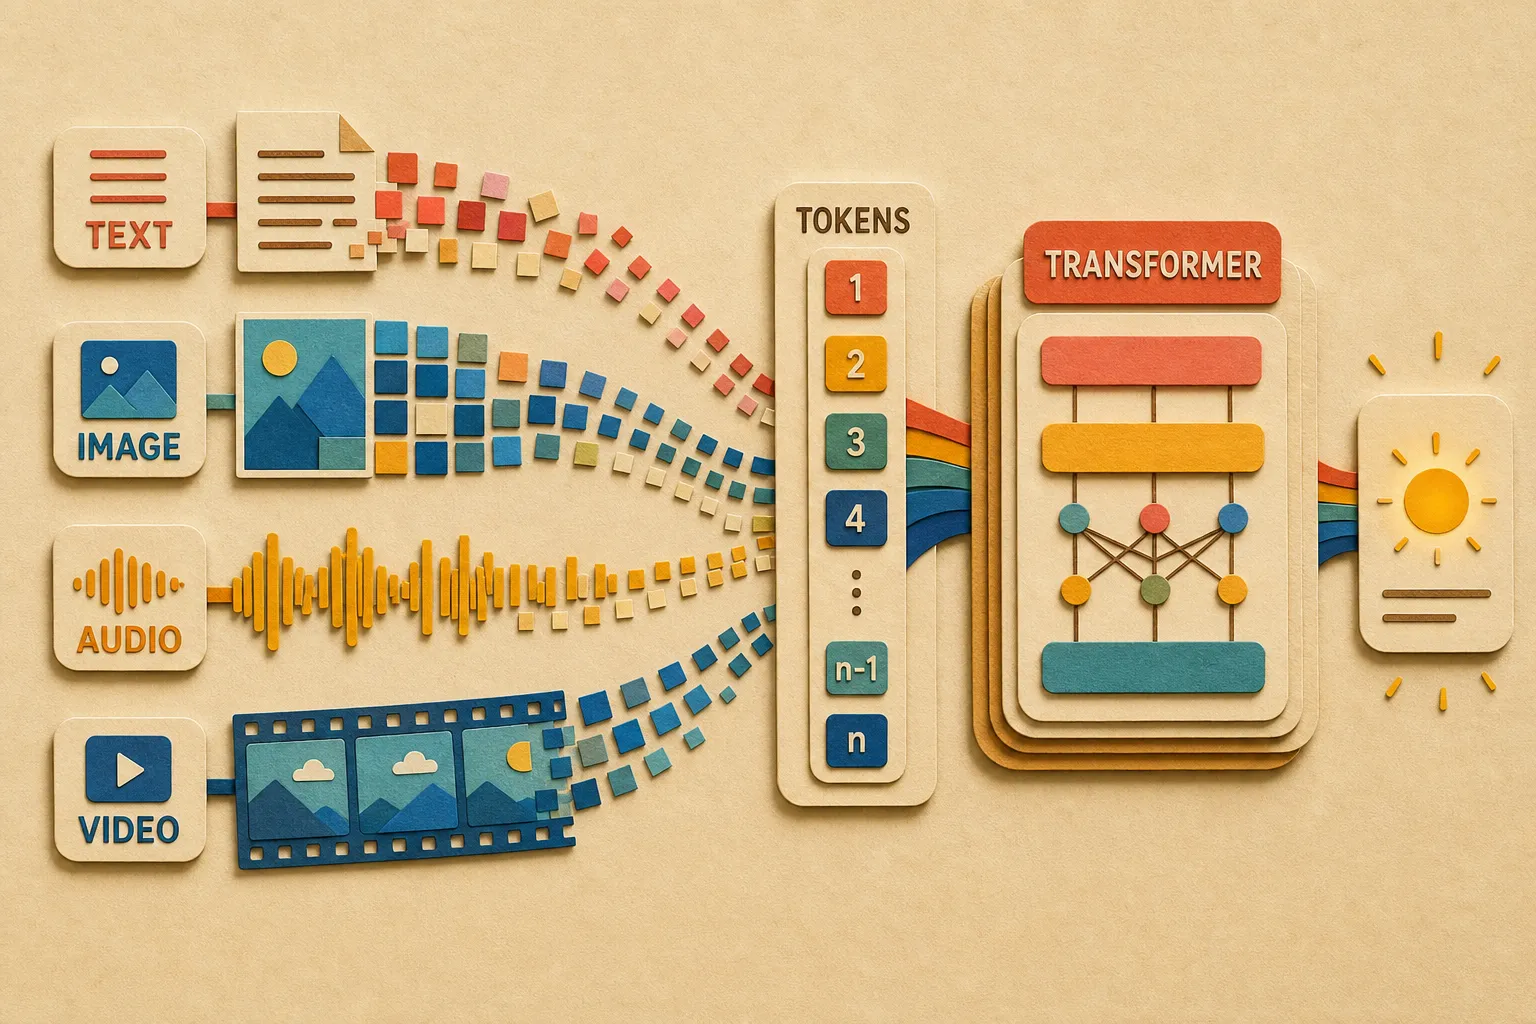
Договорённость про токены не остановилась на тексте. Трансформер это тип нейросети, который работает с последовательностями. Картинку нужно сначала превратить в такую последовательность. В 2020 году Досовицкий с коллегами из Google10 предложили решение в статье с говорящим названием «An Image is Worth 16×16 Words»: изображение режется на квадратики, например 16 на 16 пикселей, каждый квадратик получает набор чисел и дальше поступает в трансформер. С картинками тоже можно работать через последовательность числовых представлений, но правила нарезки текста к ним буквально не переносятся.
1977  Лемпель и Зив:     частые последовательности – в словарь
1991  Беккер, Unicode:   одна таблица на все письменности мира
1992  Томпсон и Пайк:    UTF-8 – номера знаков записываются байтами
1994  Гейдж:             BPE – сжатие склейкой самых частых пар
2016  Сеннрих:           BPE приходит в нейросети: таблица номеров,
                         как у Бодо и Бемера, собранная по частоте, как у Морзе
2018  Кудо, Ричардсон:   SentencePiece учится нарезке без готового деления на слова
2019  GPT-2:             склеиваются байты UTF-8, словарь покрывает любой язык
2020  Досовицкий:        картинка режется на квадратики – тоже токены
Источники
-
Ziv, Lempel, «A Universal Algorithm for Sequential Data Compression» (LZ77), 1977 – сжатие словарём, предок ZIP. Wikipedia. – https://en.wikipedia.org/wiki/LZ77_and_LZ78 ↩
-
Unicode – единая таблица знаков для всех письменностей: предложена Джо Беккером в 1988, первая версия вышла в 1991. Wikipedia. – https://en.wikipedia.org/wiki/Unicode ↩
-
Rob Pike, «UTF-8 history», 2003 – как Кен Томпсон и Роб Пайк придумали UTF-8 за ужином в закусочной в сентябре 1992. – https://www.cl.cam.ac.uk/~mgk25/ucs/utf-8-history.txt ↩
-
Philip Gage, «A New Algorithm for Data Compression», 1994 – оригинальный byte pair encoding. Wikipedia – https://en.wikipedia.org/wiki/Byte_pair_encoding ; оригинал статьи (PDF) – https://www.derczynski.com/papers/archive/BPE_Gage.pdf ↩
-
Sennrich, Haddow, Birch, «Neural Machine Translation of Rare Words with Subword Units», 2015 (ACL 2016) – статья, принёсшая алгоритм BPE в языковые модели. – https://arxiv.org/abs/1508.07909 ↩
-
Kudo, Richardson, «SentencePiece», 2018 – обучение нарезке прямо на тексте, без предварительного деления на слова. – https://arxiv.org/abs/1808.06226 ↩
-
Radford et al., «Language Models are Unsupervised Multitask Learners» (GPT-2), 2019 – BPE по байтам UTF-8: словарь покрывает любой язык. – https://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf ↩
-
Tiktokenizer – интерактивная песочница: вставь текст, увидишь токены. – https://tiktokenizer.vercel.app/ ; библиотека tiktoken (OpenAI) – https://github.com/openai/tiktoken ↩
-
Andrej Karpathy, «Let’s build the GPT Tokenizer» – токенизатор GPT, собранный с нуля. – https://www.youtube.com/watch?v=zduSFxRajkE ; код к видео, minbpe – https://github.com/karpathy/minbpe ↩
-
Dosovitskiy et al., «An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale», 2020 – картинка как последовательность токенов-квадратиков. – https://arxiv.org/abs/2010.11929 ↩