Токен остаётся удобной единицей учёта. Контекстное окно описывают количеством доступных единиц, стоимость обращения к модели часто считают за миллион входных и выходных токенов, скорость генерации в токенах в секунду. Но у этой валюты нет единого номинала. Один токен в разных системах может вместить разное количество текста. Сравнивать скорость только по числу токенов похоже на сравнение скорости чтения по числу страниц, не посмотрев на размер шрифта.
Для конкретной версии модели словарь и правила нарезки обычно фиксированы. Новая статья о компании не добавляет её имя в словарь автоматически. Но составить имя из уже доступных частей модель может. Отсутствие отдельного номера для названия не закрывает возможность работать с ним, как отсутствие слова в школьном словарике не мешает записать его знакомыми буквами.
Нарезка зависит от данных, на которых готовили токенизатор, от его устройства и от самого языка. В исследованиях многоязычных токенизаторов1 один и тот же смысл на разных языках требовал заметно разного числа токенов. При оплате по токенам это превращается и в разницу стоимости2, которую называют «токенным налогом». Смысл сообщения тот же, а контекстного окна съедается больше и счёт может оказаться выше.
Наша фраза в словаре o200k_base, используемом GPT-4o, на трёх языках. Здесь и ниже замеры сделаны библиотекой tiktoken 0.14.0 для строк без добавленных начальных и конечных пробелов:
Which camera should I buy for a blog?    37 символов    37 байт     9 токенов
Какую камеру купить для блога?           30 символов    55 байт     9 токенов
ブログ用にどのカメラを買うべきですか?       19 символов    57 байт    16 токенов
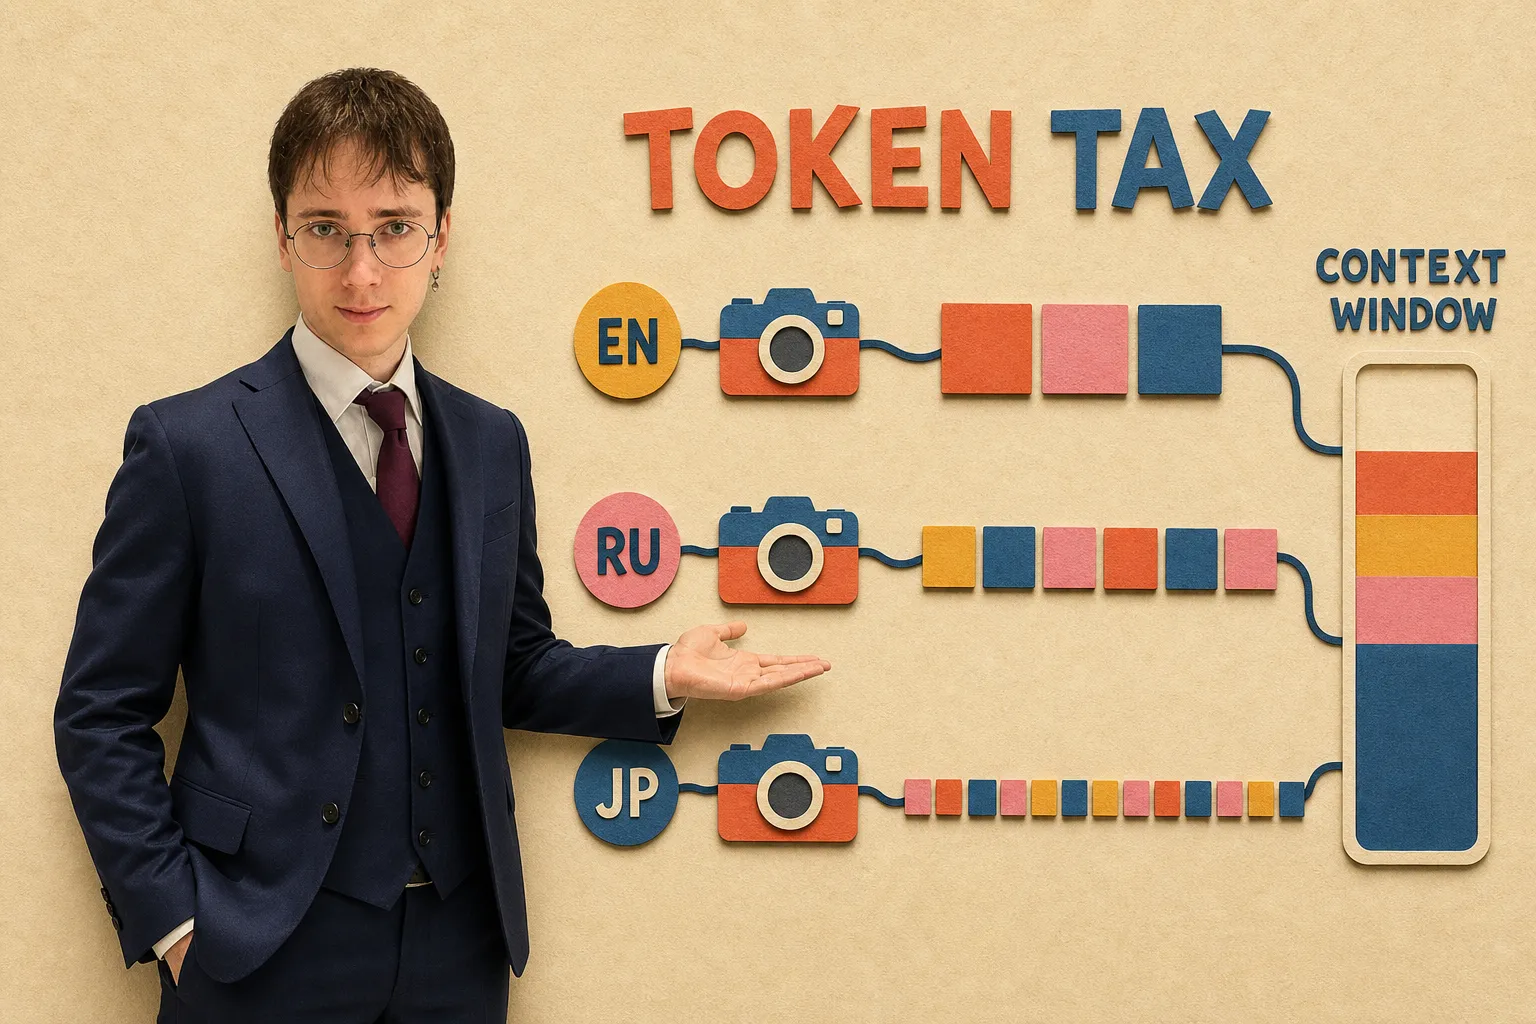
Русская фраза здесь сравнялась с английской по числу токенов, хотя байтов в ней больше. Японская занимает больше токенов, хотя видимых знаков меньше. Это результат конкретного замера, а не постоянный курс между языками. Другой текст или словарь может дать другое соотношение.
Переход к байтам тоже не делает длины одинаковыми. Тридцать семь байтов английской фразы и пятьдесят семь японской никуда не исчезают. Убирается влияние заранее собранного словаря частей слов, но остаются особенности кодировки и разная длина самих выражений. Полезно различать эти причины, чтобы не приписывать всю разницу одному BPE.
Мы превратили текст в номера: 34405, 9427… Или оставили его последовательностью байтов. Сам по себе номер всё ещё ничего не объясняет. 9427 не «больше» и не «лучше», чем 9426, это номер строки в словаре. Морзе, архиваторы, BPE и байтовые модели объясняют, как подготовить запись для вычислений. Но где в этих числах появляется смысл?
Источники
-
Petrov et al., «Language Model Tokenizers Introduce Unfairness Between Languages», 2023 – различия длины представления между языками, в том числе при переходе к символам и байтам. – https://arxiv.org/abs/2305.15425 ↩
-
Ahia et al., «Do All Languages Cost the Same? Tokenization in the Era of Commercial Language Models», 2023 – связь токенизации и стоимости использования языковых моделей. – https://arxiv.org/abs/2305.13707 ↩