Любой современный компьютер это “просто” нули и единицы, а любая LLM это “просто” матрицы с нелинейностью между ними. И над всем этим простые математические операции и наши договоренности, как это все интерпретировать. И так как ранее мы обсудили нули, единицы, матрицы и операции, эта и следующая главы будут про те самые договоренности.
Сами по себе ни нули и единицы, ни матрицы ничего не значат. Читаемая для машины запись появилась в тот момент, когда мы договорились, как кодировать и как декодировать текст. И к этой договорённости, каким способом кодировать слова числами, люди шли почти двести лет. Начиналось всё не с AI и даже не с компьютеров, а с телеграфа.
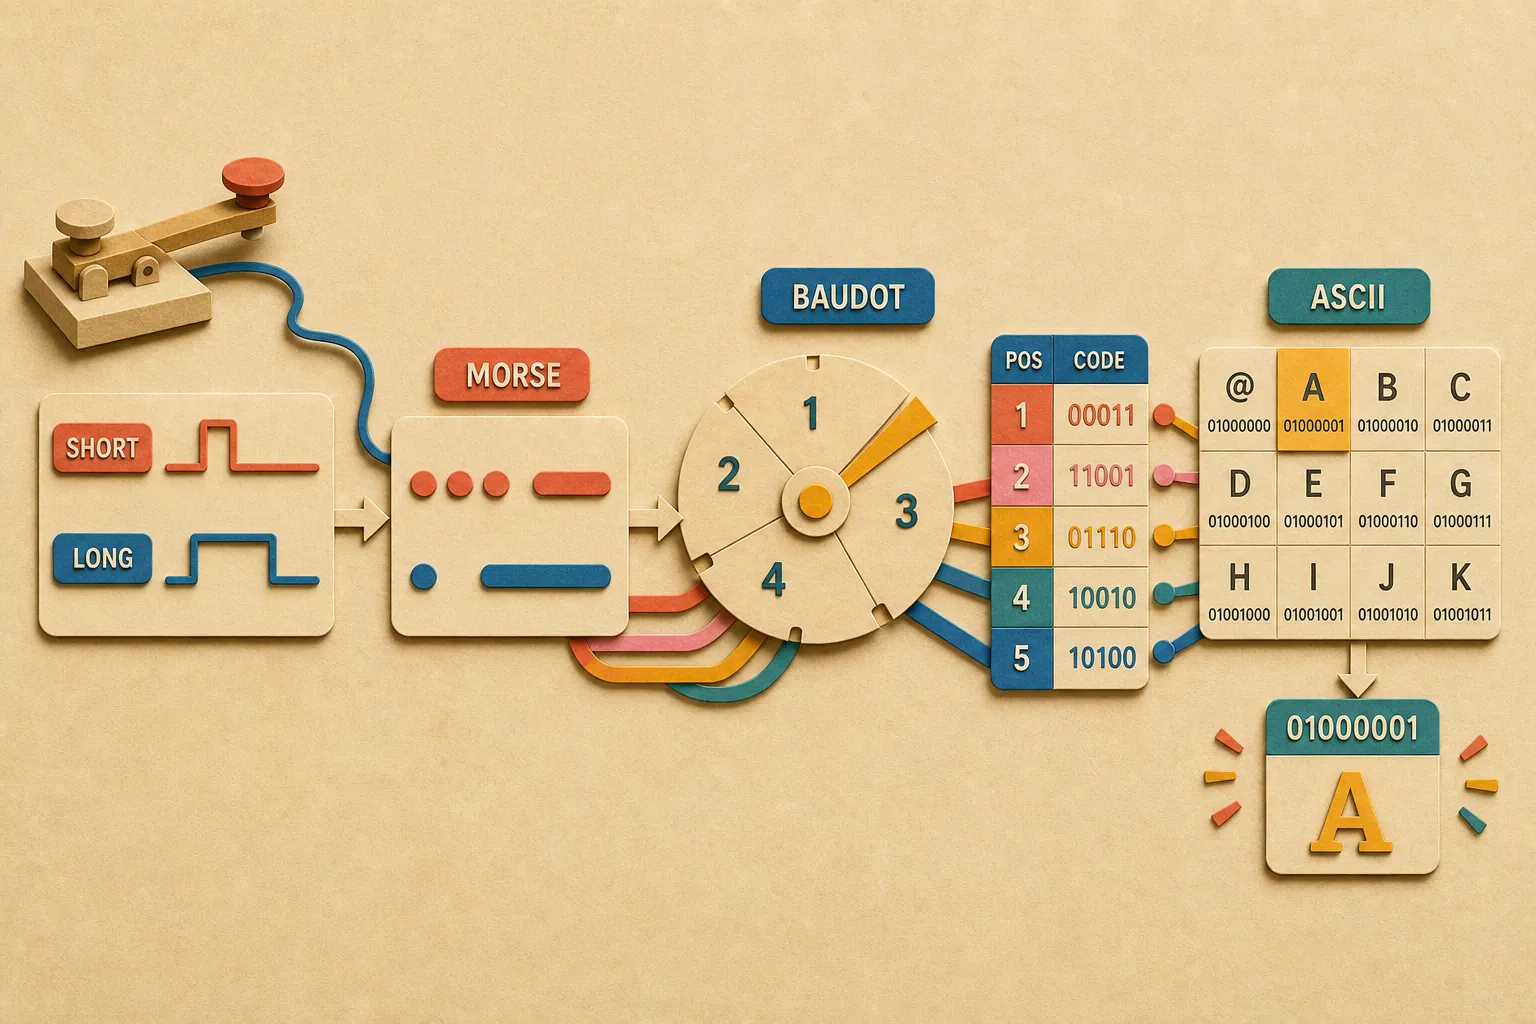
Телеграф это провод, по которому можно передать только одно: есть ток или нет тока. Нажал ключ – на другом конце провода щёлкнуло, отпустил – тишина. Те самые ноль и единица из первой главы, только за сто лет до Шеннона. Буквы по такому проводу не передашь, передашь только последовательность щелчков. И в 1838 году Морзе и Вейл1 придумывали, как записать каждую букву щелчками: короткий щелчок – точка, длинный – тире. Так появилась телеграфная азбука2. Но какой букве какой набор дать? Ответ они нашли в типографии. Текст тогда набирали вручную из металлических букв, литер, и литеры каждой буквы лежали в своём отделении ящика: под частые буквы отливали больше литер и отводили отделение побольше, под редкие – совсем маленькое. Хватило одного взгляда на такой ящик. Частой букве достался короткий код: E это одна точка. Редкой – длинный: Q это тире-тире-точка-тире. Так в кодирование пришла идея, на которой стоит вся эта подглава: частое кодируй коротко, редкое – длинно, и сообщение в среднем станет короче.
У кода Морзе был один недостаток: принимать его умел только человек. Точки, тире и паузы между ними разной длины, и где кончилась одна буква и началась следующая, телеграфист определял на слух, по ритму. Пока на приёме сидел человек, это никого не смущало. Но к 1870-м телеграфные линии стали узким местом: провод между городами стоил дорого, а разговор по нему шёл только один.
Эмиль Бодо3 в 1874 году придумал, как пустить по одному проводу сразу несколько: на обоих концах с одинаковой скоростью крутятся два диска, каждый оборот делится на равные доли, первая доля отдана первому телеграфисту, вторая – второму, и так по кругу. Чтобы это работало, в каждую долю должна помещаться ровно одна буква, а значит, все буквы должны быть одной длины. С кодом Морзе, где E в десять с лишним раз короче Q, такое не собрать. И Бодо дал каждой букве код ровно из пяти сигналов: ток есть или тока нет, пять раз подряд. Экономия Морзе пропала, зато приёмнику больше не нужен слух: он отсчитывает пять сигналов, находит их в таблице из 32 строк и печатает букву сам, без человека. Буква стала номером строки в таблице.
Спустя семьдесят лет в 1948 году Клод Шеннон4 (тот самый из первой главы, который в 1937 году заметил, что и сами 0 и 1, и все три операции можно реализовать в электрических схемах) показал, что количество информации в сообщении можно измерить, и что предсказуемое сжимается: чем точнее угадывается продолжение, тем меньше битов нужно для передачи. А в работе 1951 года5 он поставил эксперимент, который сегодня читается как описание “Человеческого GPT”: сажал человека угадывать текст букву за буквой и по точности угадывания измерял предсказуемость английского языка. Ключевая идея – простое предсказание следующего кусочка текста как способ ухватить весь язык целиком. Шеннон делал это на людях за семьдесят лет до языковых моделей. А годом позже студент MIT Дэвид Хаффман6 закрыл вопрос, который Морзе решал на глаз: придумал алгоритм, который строит наилучший частотный код для любых данных. Его код до сих пор работает внутри каждого ZIP-файла.
Таблица Бодо дожила до компьютеров, и там история повторилась в большом масштабе. Внутри компьютера буква тоже хранится как номер в таблице, только к концу 1950-х таблица у каждого производителя была своя: у одной только IBM было несколько несовместимых таблиц, и две машины из соседних отделов не могли обменяться текстом. Боб Бемер7 из IBM вспоминал, что окончательно его добила мысль о текстовых редакторах: им нужны и заглавные, и строчные буквы, а в старые 64 символа они не помещались. Решение оказалось не техническим, а человеческим: собрать комитет и договориться. В 1963 году вышла таблица ASCII8: одна на всех, 128 знаков, у каждого свой номер. Бемера с тех пор зовут отцом ASCII, ему же мы обязаны клавишей Escape, обратным слешем и фигурными скобками. Это договорённость в самом буквальном смысле слова: люди из разных компаний сели за стол и условились, какое число какую букву значит. И договорённость решает всё: один и тот же байт 01000001 это буква «A» по ASCII, число 65 по Лейбницу и оттенок серого, если читать его как пиксель. Сами биты смысла не имеют. Смысл живёт в интерпретации.
1838  Морзе и Вейл:    частой букве – короткий код
1874  Бодо:            каждой букве – код одной длины, буква = номер в таблице
1948  Шеннон:          предсказуемое сжимается; язык можно измерить,
                       угадывая следующую букву
1952  Хаффман:         наилучший частотный код
1963  Бемер, ASCII:    одна таблица «число = буква» на всех
Так к 1963 году текст научились хранить в машине: буква равна числу, таблица одна на всех. Линия Морзе, где частое кодируется коротко, тем временем шла своим путём.
Источники
-
Alfred Vail – соавтор азбуки Морзе; именно ему приписывают подсчёт букв в типографской кассе. Wikipedia. – https://en.wikipedia.org/wiki/Alfred_Vail ↩
-
Азбука Морзе – первое частотное кодирование текста, 1838. Wikipedia. – https://en.wikipedia.org/wiki/Morse_code ↩
-
Émile Baudot, код Бодо, 1874 – первый код фиксированной длины: буква = пять единиц, текст стал читаем для машины. Wikipedia. – https://en.wikipedia.org/wiki/Baudot_code ↩
-
Claude Shannon, «A Mathematical Theory of Communication», 1948 – работа, породившая теорию информации. – https://people.math.harvard.edu/~ctm/home/text/others/shannon/entropy/entropy.pdf ↩
-
Claude Shannon, «Prediction and Entropy of Printed English», 1951 – предсказуемость языка, измеренная угадыванием следующей буквы. – https://www.princeton.edu/~wbialek/rome/refs/shannon_51.pdf ↩
-
David Huffman, «A Method for the Construction of Minimum-Redundancy Codes», 1952 – оптимальный частотный код, прямой наследник идеи Морзе; вместе с LZ77 работает внутри каждого ZIP. Wikipedia. – https://en.wikipedia.org/wiki/Huffman_coding ↩
-
Bob Bemer – «отец ASCII», инженер IBM, добившийся единой таблицы символов. Wikipedia. – https://en.wikipedia.org/wiki/Bob_Bemer ↩
-
ASCII – договорённость «байт = символ», принятая комитетом в 1963. Wikipedia. – https://en.wikipedia.org/wiki/ASCII ↩