現代のコンピュータは、どれも「ただの」0と1です。LLMはどれも「ただの」行列で、そのあいだに非線形性が挟まっているだけです。そしてそのすべての上に、単純な数学的演算と、それをどう解釈するかについての私たちの取り決めがあります。0と1、行列、演算についてはすでに話しました。この章と次の章は、その取り決めについての話です。
0と1も行列も、それ自体では何も意味しません。機械が読める記録が生まれたのは、テキストをどう符号化し、どう復号するかを私たちが取り決めたときです。そして、言葉をどんな方法で数として符号化するかというこの取り決めに、人類はおよそ二百年かけてたどり着きました。始まりはAIではなく、コンピュータですらなく、電信でした。
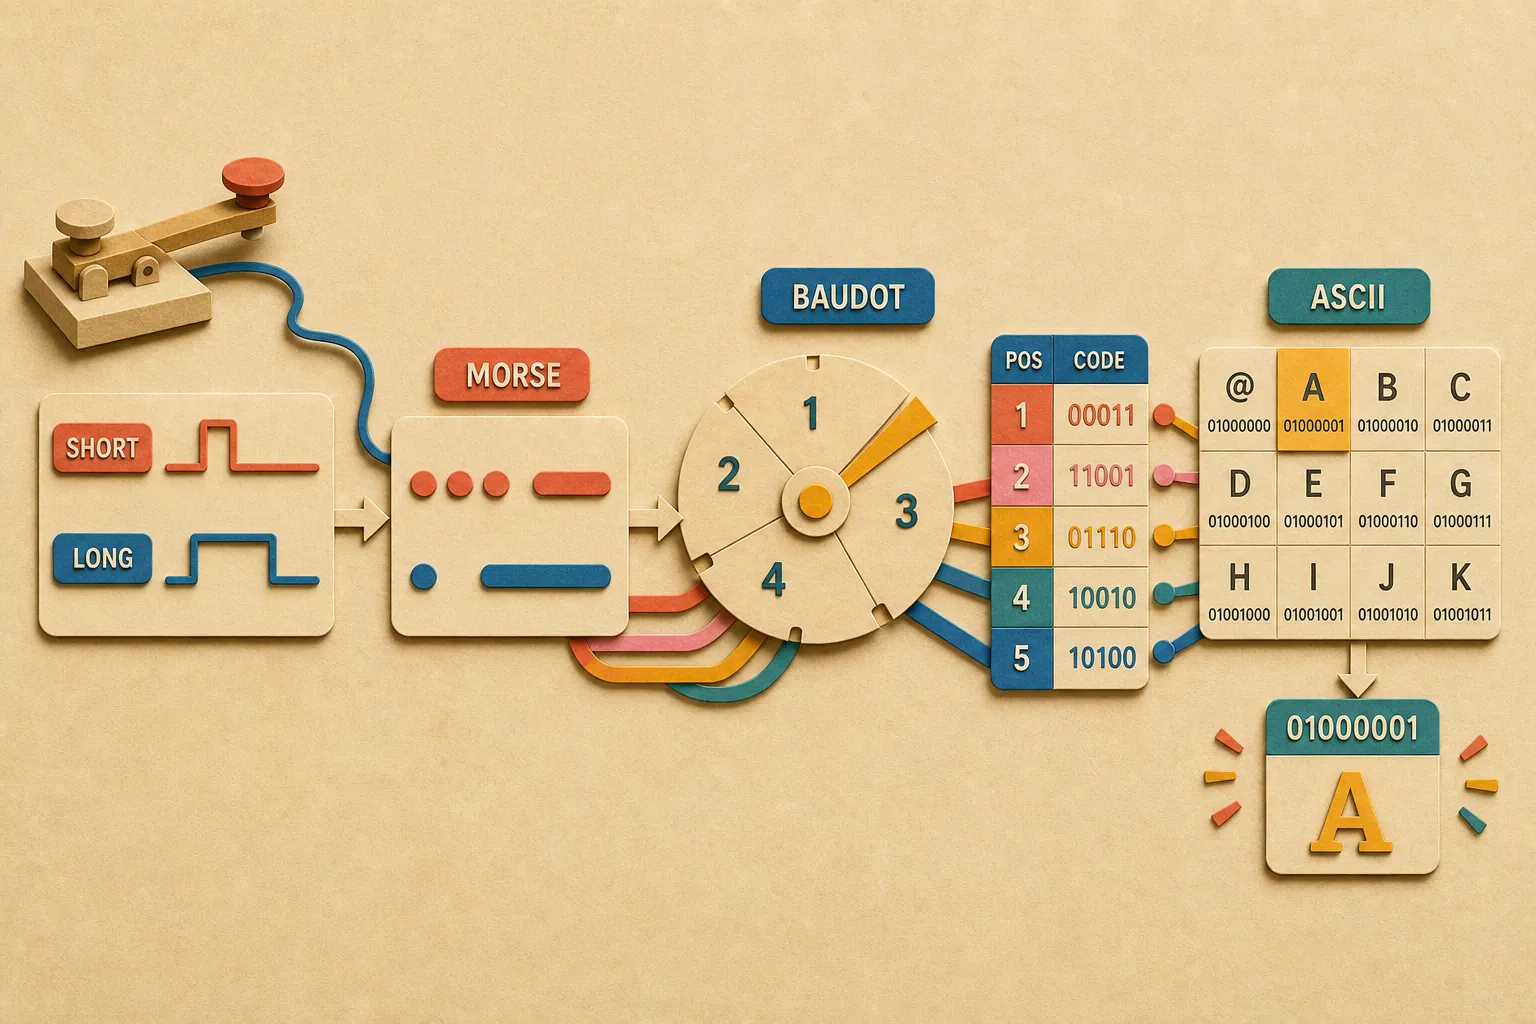
電信とは、たったひとつのことしか伝えられない電線です。電流が流れているか、いないか。キーを押すと電線の向こう端でカチッと鳴り、離すと静かになります。第1章で見たあの0と1です。ただし、シャノンより百年早く。そんな電線で文字は送れません。送れるのはクリック音の並びだけです。そこで1838年、モールス(Morse)とヴェイル(Vail)1は、それぞれの文字をクリック音で書き表す方法を考えました。短いクリックは点(トン)、長いクリックは線(ツー)。こうしてモールス符号2が生まれました。では、どの文字にどの組み合わせを与えればいいのか。答えは印刷所にありました。当時、文章は金属の文字、つまり活字を手で並べて組んでいて、文字ごとの活字は活字ケースのそれぞれの仕切りに収められていました。よく使う文字は活字を多めに鋳造して大きな仕切りを割り当て、まれな文字にはごく小さな仕切りしかありませんでした。そのケースをひと目見れば十分でした。よく使う文字には短い符号を。Eは点ひとつです。まれな文字には長い符号を。Qは線・線・点・線です。こうして符号化に、この節全体の土台になるアイデアがもたらされました。よく出てくるものは短く、まれなものは長く符号化する。そうすれば、メッセージは平均して短くなります。
モールス符号には欠点がひとつありました。受信できるのが人間だけだったのです。点と線、そしてそのあいだの間(ま)は長さがまちまちで、ひとつの文字がどこで終わり、次の文字がどこから始まるのかを、電信士は耳で、リズムで聞き分けていました。受信側に人が座っているうちは、それで誰も困りませんでした。しかし1870年代になると、電信線がボトルネックになってきます。都市間を結ぶ電線は高価なのに、一度にひとつの会話しか通せなかったのです。
1874年、エミール・ボード(Émile Baudot)3は、一本の電線に複数の会話を同時に通す方法を考えました。両端で二枚の円盤が同じ速さで回転し、一回転は等しい区間に分けられます。最初の区間は一人目の電信士のもの、二番目は二人目のもの、という具合に順番に回っていきます。これが機能するには、どの区間にもちょうど一文字が収まらなければなりません。つまり、すべての文字が同じ長さでなければならないのです。EがQの10分の1以下の長さしかないモールス符号では、こんな仕組みは組み立てられません。そこでボードは、すべての文字に、きっかり五つの信号からなる符号を与えました。電流があるか、ないか。それを五回続けて。モールスの節約は失われましたが、そのかわり受信機に耳はもう必要ありません。信号を五つ数え、32行の表でそれを探し、人の手を借りずに自分で文字を印字します。文字は、表の行番号になりました。
それから70年後の1948年、クロード・シャノン4(第1章に登場した、1937年に0と1そのものも三つの演算もすべて電気回路で実現できると気づいた、あのシャノンです)は、メッセージに含まれる情報の量は測れること、そして予測できるものは圧縮できることを示しました。続きを正確に当てられるほど、送るのに必要なビットは少なくて済みます。そして1951年の論文5で、彼はある実験を行いました。今読むと「人間GPT」の説明のように見える実験です。被験者に文章を一文字ずつ当てさせ、その的中率から英語の予測可能性を測ったのです。核心にあるアイデアは、テキストの次の一片を予測するという単純なことが、言語全体をつかむ方法になるということです。シャノンはこれを、言語モデルより70年も前に、人間を相手にやっていました。そしてその翌年、MITの学生だったデイヴィッド・ハフマン(David Huffman)6が、モールスが目分量で解いていた問題に決着をつけました。どんなデータに対しても最適な頻度符号を作るアルゴリズムを考案したのです。彼の符号は、今もすべてのZIPファイルの中で動いています。
ボードの表はコンピュータの時代まで生き延び、そこで同じ物語がより大きな規模で繰り返されました。コンピュータの中でも、文字は表の中の番号として保存されます。ただ、1950年代の終わりには、表はメーカーごとにばらばらでした。IBM一社だけでも互換性のない表がいくつもあり、隣の部署の二台の機械どうしでテキストをやり取りすることさえできませんでした。IBMのボブ・ビーマー(Bob Bemer)7は、最後のひと押しになったのはテキストエディタのことを考えたときだったと振り返っています。テキストエディタには大文字も小文字も必要なのに、古い64文字には収まりきらないのです。解決策は技術的なものではなく、人間的なものでした。委員会を作って、合意すること。1963年、ASCII表8が登場しました。全員共通のひとつの表で、128の文字それぞれに固有の番号があります。以来ビーマーは「ASCIIの父」と呼ばれています。Escキー、バックスラッシュ、波かっこも彼のおかげです。これは文字どおりの意味での取り決めです。さまざまな会社の人々がひとつのテーブルを囲み、どの数がどの文字を意味するのかを決めたのです。そして、取り決めがすべてを決めます。同じバイト01000001が、ASCIIでは文字の「A」、ライプニッツの方式では数の65、ピクセルとして読めば灰色の濃淡のひとつになります。ビットそれ自体には意味がありません。意味は解釈の中に宿るのです。
1838  モールスとヴェイル:  よく使う文字に短い符号を
1874  ボード:              すべての文字に同じ長さの符号を。文字 = 表の番号
1948  シャノン:            予測できるものは圧縮できる。言語は
                            次の文字を当てることで測れる
1952  ハフマン:            最適な頻度符号
1963  ビーマー、ASCII:     「数 = 文字」を定めた全員共通の表
こうして1963年までに、テキストを機械に保存できるようになりました。文字は数であり、表は全員共通のひとつです。一方、よく使うものを短く符号化するモールスの系譜は、その間も独自の道を歩んでいました。
出典
-
Alfred Vail。モールス符号の共同考案者。印刷所の活字ケースの文字を数えたのは彼だとされる。Wikipedia。 — https://en.wikipedia.org/wiki/Alfred_Vail ↩
-
モールス符号。テキストの最初の頻度にもとづく符号化(1838年)。Wikipedia。 — https://en.wikipedia.org/wiki/Morse_code ↩
-
Émile Baudot、ボード符号(1874年)。最初の固定長符号。文字 = 5単位になり、テキストが機械で読めるようになった。Wikipedia。 — https://en.wikipedia.org/wiki/Baudot_code ↩
-
Claude Shannon, “A Mathematical Theory of Communication,” 1948. 情報理論を生んだ論文。 — https://people.math.harvard.edu/~ctm/home/text/others/shannon/entropy/entropy.pdf ↩
-
Claude Shannon, “Prediction and Entropy of Printed English,” 1951. 次の文字を当てさせることで測定した、言語の予測可能性。 — https://www.princeton.edu/~wbialek/rome/refs/shannon_51.pdf ↩
-
David Huffman, “A Method for the Construction of Minimum-Redundancy Codes,” 1952. 最適な頻度符号で、モールスのアイデアの直系の子孫。LZ77とともに、すべてのZIPの中で動いている。Wikipedia。 — https://en.wikipedia.org/wiki/Huffman_coding ↩
-
Bob Bemer。「ASCIIの父」。共通の文字コード表を実現させたIBMのエンジニア。Wikipedia。 — https://en.wikipedia.org/wiki/Bob_Bemer ↩
-
ASCII。「バイト = 文字」という取り決め。1963年に委員会で採択された。Wikipedia。 — https://en.wikipedia.org/wiki/ASCII ↩