何よりもどかしいのは、解決策がすぐ目の前にあったことです。しかも私たちは、それをすでに見ています。コンピュータを思い出してください。命令ひとつでできることも、ごくわずかです。しかし命令を順に並べ、それぞれが前の命令の結果を受けて動くようにすれば、どんなことでもこなせます。どんな数学でも計算でき、どんな論理でも再現できます。一歩で天井にぶつかるなら、何歩も進めばいい。同じ発想をニューロンにも当てはめてみましょう。答えを「掛けて足す」一回から作るのではなく、そうしたステップの鎖から作るのです。一歩は行列の掛け算ひとつなので、掛け算を鎖のように並べます。ベクトルに一つ目の行列を掛け、その結果に二つ目を掛け、さらに三つ目を掛け、と続けていきます。
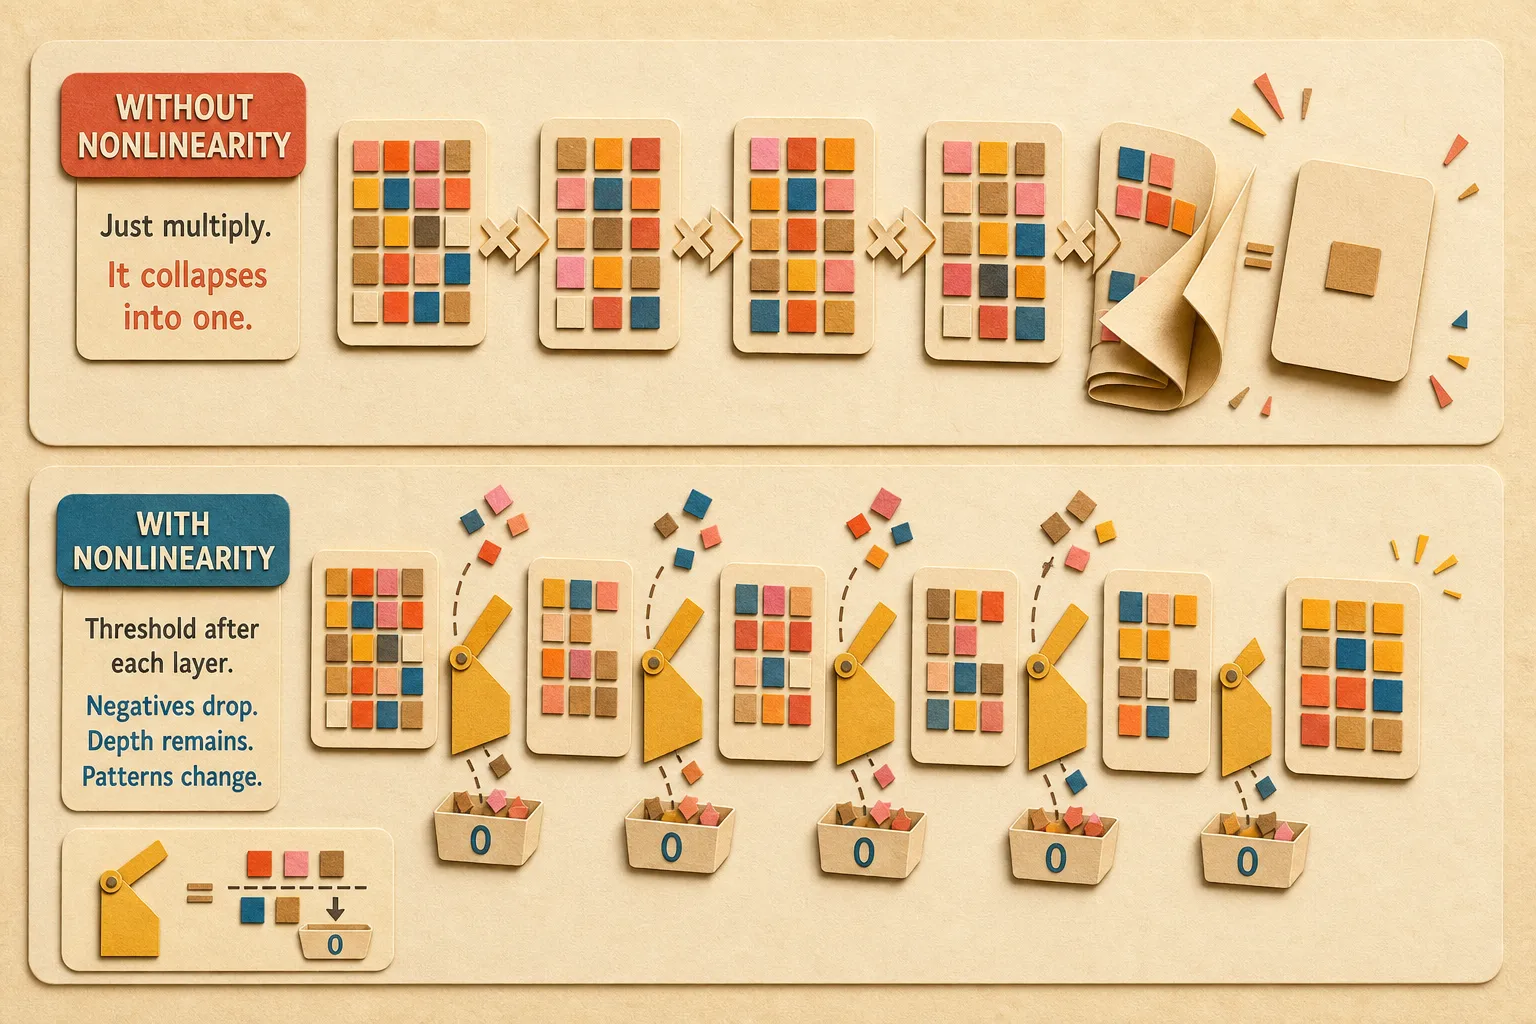
ところが、ただ行列をたくさん並べればいい、というわけにはいきません……。どの行列もあらかじめ決まっていて、入力として何が来るかには左右されません。そして、あらかじめ決まっているものは、あらかじめ計算しておけます。百個の行列を一度掛け合わせてしまえば、ひとつの行列になるのです。
V × M₁ × M₂ × M₃ = V × (M₁ M₂ M₃) = V × M_one
この単純な式変形が、アイデアを丸ごと台無しにします。百個の行列の鎖は、ひとつの行列とまったく同じように働くのです。数学者ならこう言うでしょう。「等価である!」。ミンスキーとパパートの壁は、少しも消えていません。
その代わり、何が必要なのかははっきりしました。鎖がつぶれないようにすればいいのです。鎖がつぶれるのは、それが掛け算と足し算だけでできているからです。ならば、掛け算と掛け算のあいだに、掛け算と足し算では表せないもの、つまり非線形な何かを挟めばいい!
そしてその非線形な操作は、笑ってしまうほど小さなもので構いません。今日の標準はReLU1というルールで、「数が負なら0に置き換える」だけです。よく見てください。これは条件、つまり「もし」です。「掛けて足す」にはまったくなかったものです。でも、生きたニューロンはずっとそれを持っていました。あのしきい値、「発火するか、黙っているか」こそが自然の非線形性で、それはマカロックとピッツのモデルにもすでにありました。むき出しの掛け算を鎖のように並べたとき、私たちはそれを失っていたのです。いまはそれを元の場所に戻すだけです。どの数が0になるかは入力データによって決まり、入力によって決まるものは、あらかじめ計算しておくことができません。こうして鎖はつぶれなくなり、各ステップが答えにそれぞれ独自のものを加え始め、百個の行列はついに、百回の本物の演算になります。このような鎖、つまり行列の掛け算のあいだに非線形性を挟んだものが、ニューラルネットワークと呼ばれます。そしてその各ステップ、つまり行列と非線形性の組が「層」と呼ばれます。
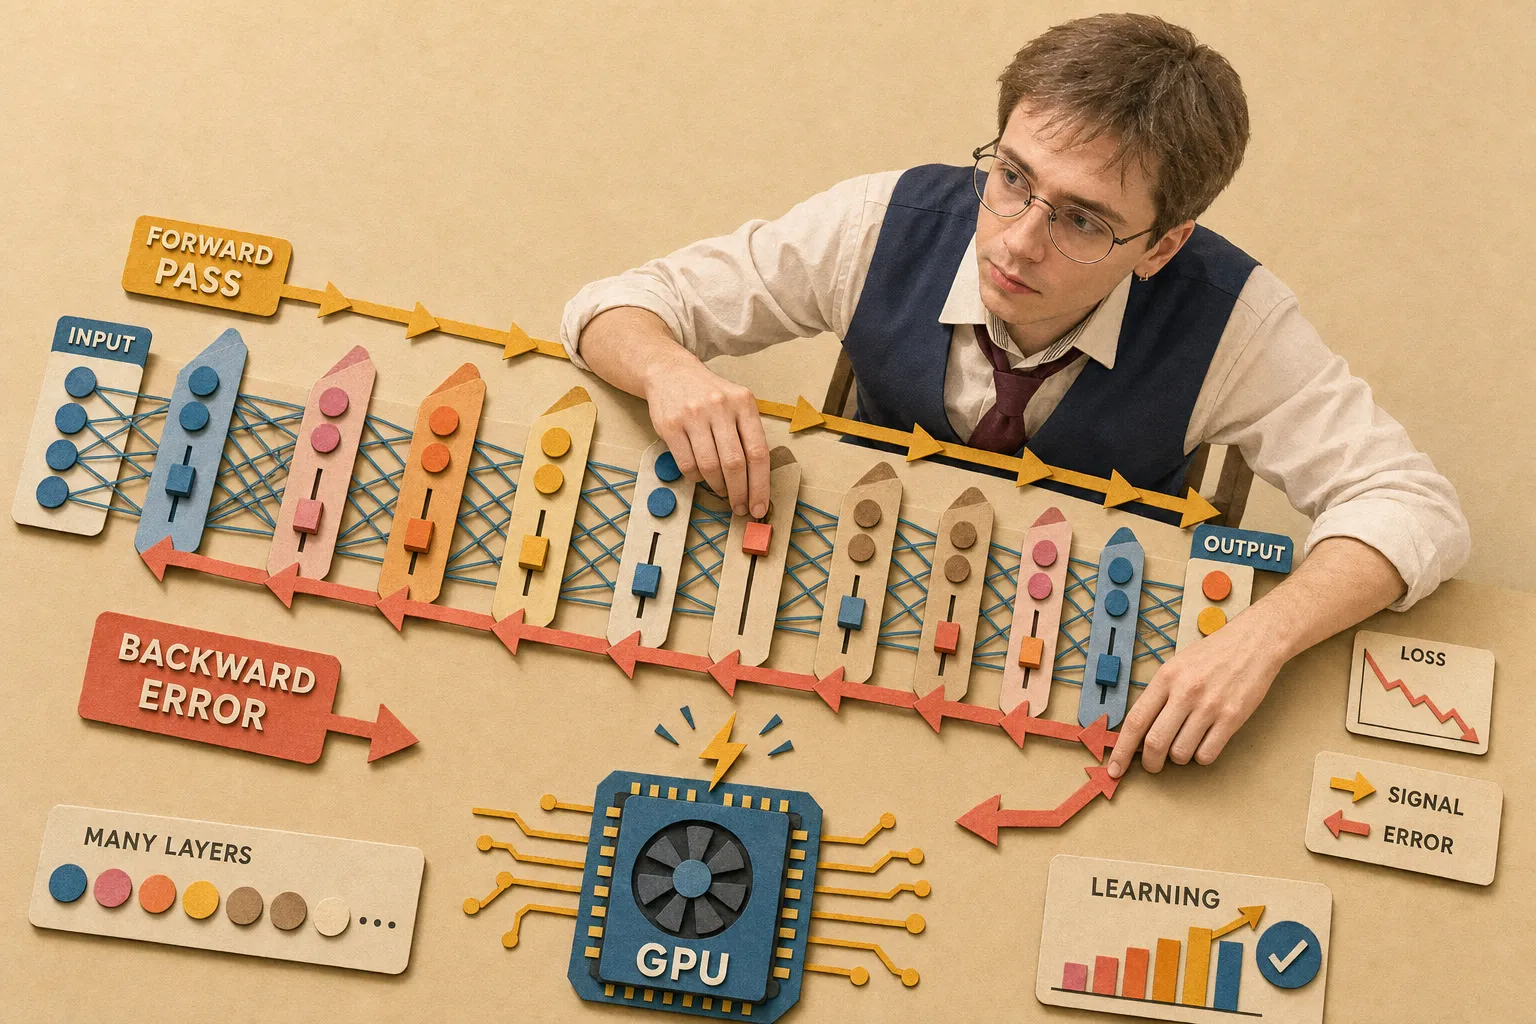
なぜそんなに多くの層が必要なのでしょうか。プログラムに多くの命令が必要なのと同じ理由です。次の層はどれも前の層の結果を受けて働き、複雑さが積み重なっていきます。最初の層は文字を単語にまとめ、中間の層は意味を取り出し、後半の層が答えそのものを形づくります。のちに数学者たちは、浅いネットワークで同じ仕事をするには天文学的に多くのニューロンが必要になることを厳密に証明しました2。これをもっとも美しく見せてくれるのが、3Blue1Brown3のビジュアライゼーションです。行列ひとつは、数式ひとつ。百の層は、もう百の順を追ったステップと条件からなるプログラムです。そして両者の違いは、電卓と知性の違いと同じです。
残る問いは、こうした多層のネットワークをどうやって学習させるか、でした。1986年、ラメルハート(Rumelhart)、ヒントン(Hinton)、ウィリアムズ(Williams)4が、今も使われている答えを示しました。出力での誤差を、すべての層を通して逆向きに送り、各行列を調整していくのです。この方法はbackpropagation(誤差逆伝播法)と名づけられました。そして深さが本当に威力を発揮し始めたのは2012年、ゲーム用のGPUで動くネットワークAlexNet5が、画像認識のコンテストで他を圧倒したときです。それ以来、層は数十、数百と数えられるようになりました。GPT-36は96層、Llama 3.1 405B7はすでに126層です。こうしたネットワークが「深い」と呼ばれ、分野全体がdeep learning(深層学習)と呼ばれるのは、まさにそのためです。
行列の鎖:          むき出しの掛け算は、ひとつの行列につぶれてしまう
                      ↓
非線形性:          掛け算のあいだの「もし」で、鎖はつぶれなくなる。
                    こうして行列は、層からなるニューラルネットワークになる
                      ↓
ヒントンら:        誤差が多くの層を一度に学習させる(backpropagation)
                      ↓
ReLUとGPU:         深さが機能し始め、層は数百にまで増えた
こうして、単純な0と1だけでコンピュータのあらゆる魔法を生み出せるのとまったく同じように、あいだに非線形性を挟んだ単純な行列だけで、知性という魔法を生み出せることがわかったのです。
これがすべての土台であり、とんでもなくすごいことです。 でも、これはまだ始まりにすぎません!
出典
-
Glorot, Bordes, Bengio, “Deep Sparse Rectifier Neural Networks,” 2011. ReLUを深層ネットワークの標準にした論文。 — https://proceedings.mlr.press/v15/glorot11a/glorot11a.pdf ↩
-
Telgarsky, “Benefits of Depth in Neural Networks,” 2016. 深さの利点の厳密な証明。 — https://arxiv.org/abs/1602.04485 ↩
-
3Blue1Brown, “But what is a neural network?” ニューラルネットワークの仕組みを示す、最高のビジュアライゼーション。 — https://www.youtube.com/watch?v=aircAruvnKk ↩
-
Rumelhart, Hinton, Williams, “Learning Representations by Back-Propagating Errors,” Nature, 1986. 多層ネットワークを学習させる方法、backpropagation。 — https://www.cs.toronto.edu/~hinton/absps/naturebp.pdf ↩
-
Krizhevsky, Sutskever, Hinton, “ImageNet Classification with Deep CNNs” (AlexNet), 2012. ディープラーニングがGPU上で威力を発揮し始めた瞬間。 — https://proceedings.neurips.cc/paper_files/paper/2012/file/c399862d3b9d6b76c8436e924a68c45b-Paper.pdf ↩
-
Brown et al., “Language Models are Few-Shot Learners”(GPT-3の論文), 2020. — https://arxiv.org/abs/2005.14165 ↩
-
Llama Team (Meta), “The Llama 3 Herd of Models,” 2024. — https://arxiv.org/abs/2407.21783 ↩