その後、「よく使うものは短く」というアイデアを、圧縮ツールが自動化の域にまで高めました。1977年、レンペル(Lempel)とジヴ(Ziv)1は、辞書を使ってデータを圧縮する方法を提案しました。頻繁に繰り返される並びを辞書に登録し、テキストの中ではそのかわりに短い参照を置くのです。あなたのディスクにあるZIPファイルはどれも、このアイデアの子孫で動いています。
一方、文字コード表の系譜は、やがて自分自身の天井にぶつかりました。ビーマーの表には128文字しかありません。英語のアルファベット、数字、句読点、そして制御コードです。ほかの文字体系が入る余地はありません。各国はASCIIの上に独自の表を作りました。日本ではShift JIS、ロシアではKOI-8、のちにWindows-1251。どの表も、自国の文字に独自の番号を振っていました。ある表で書かれたテキストを別の表で開くと、でたらめな記号のごみに変わってしまいます。日本語ではこの現象に「文字化け」という名前までつき、1980年代には、海外にファイルを送ったことのある人なら誰もが知っていました。1988年、ゼロックスのジョー・ベッカー(Joe Becker)2は、世界のあらゆる文字体系をまとめてひとつの表にすることを提案し、1991年にUnicodeが登場しました。Unicodeは少しずつ拡張され、さまざまな文字体系の文字が加えられ、のちには絵文字も加わりました。残る問題は、そんな表の番号を、古いASCIIファイルを壊さずにどうやってバイトで書き表すかでした。1992年、ケン・トンプソン(Ken Thompson)とロブ・パイク(Rob Pike)3は、ニュージャージーのダイナーで夕食をとりながら、紙ナプキンにUTF-8をざっと描きました。英語の文字はビーマーのときと同じく1バイトのまま、ロシア語の文字は2バイト、漢字の多くは3バイト。今日、インターネットのほぼすべてがこのエンコーディングで保存されていて、言語モデルの入り口にあるのもこれです。
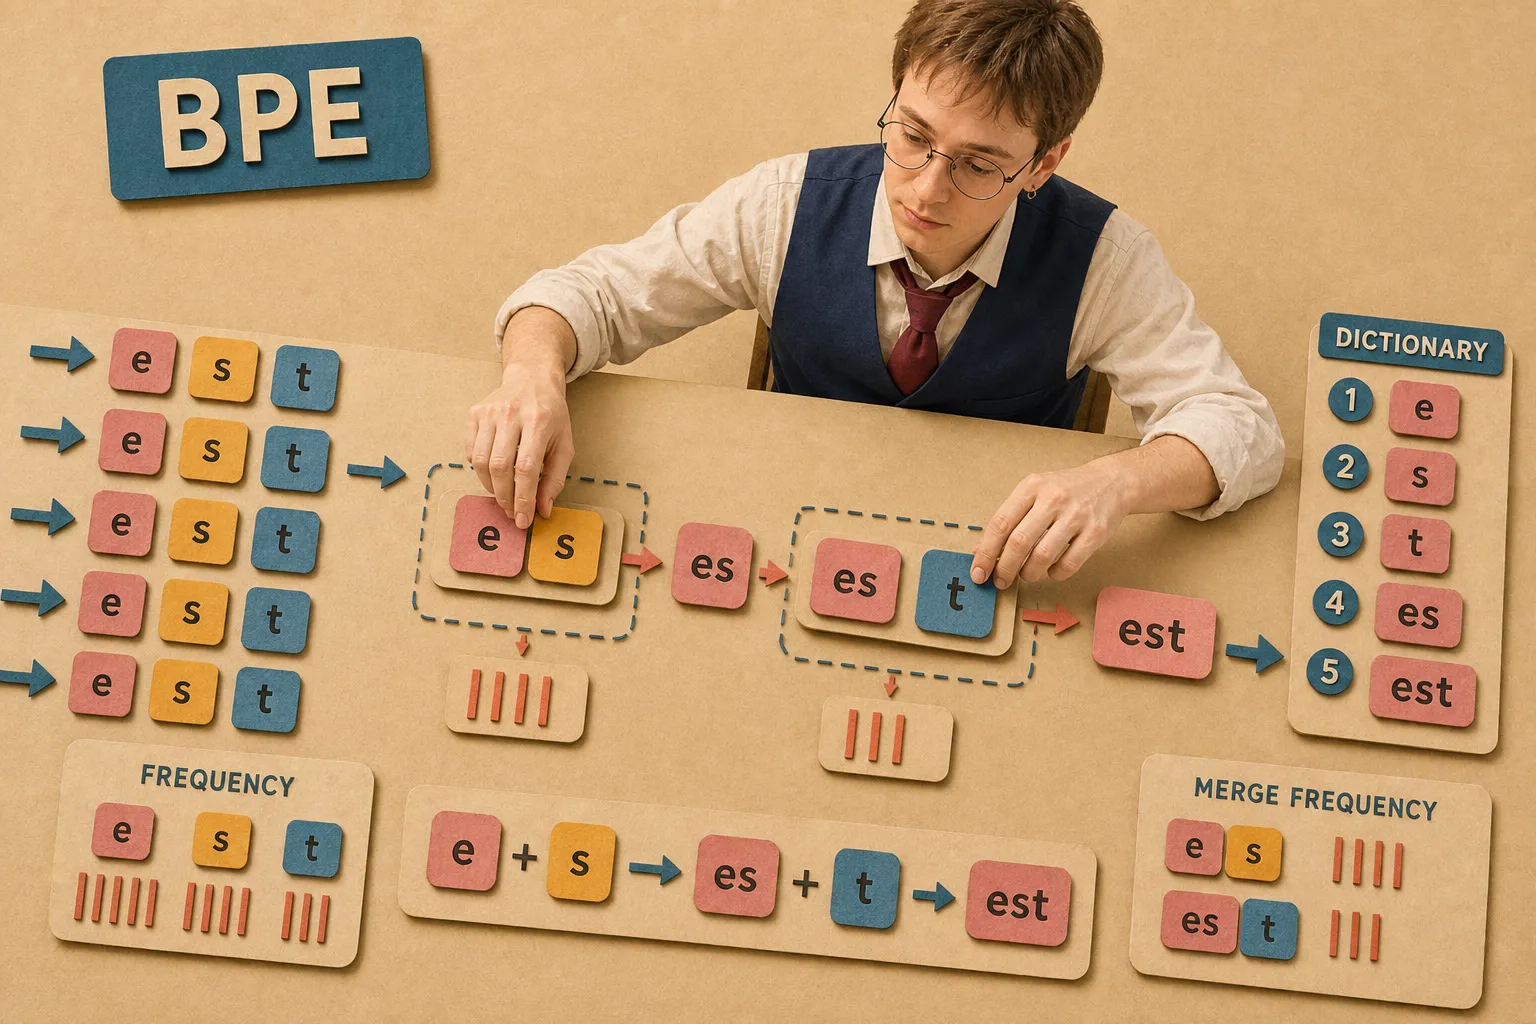
そして1994年、フィリップ・ゲージ(Philip Gage)4は、辞書式圧縮のごく単純な一種を発表しました。byte pair encoding(バイト対符号化)、略してBPEです。データの中でもっとも頻繁に現れる、隣り合った記号のペアを見つける。それを新しいひとつの記号に結合し、辞書に加える。辞書が目標の大きさになるまで、これを繰り返します。low、lower、newest、widestという単語からなる小さなコーパスでは、最初のステップは次のようになります。
ステップ1: 最頻ペア  e + s   (9回)  →  新しい記号  es
ステップ2: 最頻ペア  es + t  (9回)  →  新しい記号  est
ステップ3: 最頻ペア  est + _ (9回)  →  新しい記号  est_
ステップ4: 最頻ペア  l + o   (7回)  →  新しい記号  lo
接尾辞の「-est」と語根の「lo」が、文法規則をひとつも使わずに、文字の中からひとりでに育ってきます。アルゴリズムは、それが言語であることなど気にしません。見ているのは頻度だけです。
モールスからゲージまで、これはすべて節約のためでした。電信料金の、ディスク容量の。知性のことなど誰も考えていませんでした。行列のときとまったく同じです。道具は、そのいちばん大事な仕事よりずっと前に現れていたのです。
ニューラルネットワークへの橋が架かったのは2016年で、理由は純粋に実用的なものでした。ニューラル機械翻訳では、テキストをどんな単位に切ってモデルに食べさせるかを決める必要があり、すぐに思いつく二つの選択肢には、それぞれ代償がありました。
文字単位:  語彙は小さいが、並びが長くなる。
            モデルが処理しなければならない単位が増える
単語単位:  すべての単語を前もって列挙することはできない。固有名詞、タイプミス、新語……
            語彙にない単語 = 「正体不明」
ゼンリッヒ(Sennrich)ら5は、20年前の圧縮アルゴリズムであるBPEを持ち出し、ちょうどよい中間点を見つけました。語彙を、データから自分自身で組み立てさせるのです。よく使われる単語は丸ごとトークンになれますし、まれな単語はなじみのある断片から、場合によっては一文字ずつにまで分けて組み立てられます。もう、新しい単語のたびに語彙に新しい行を加える必要はありません。
その結果できたのは、ボードやビーマーのときと同じような表です。どの記号にも固有の番号があります。ただし、この表の大きさは開発者が選びます。数万行から数十万行です。そして断片そのものは、モールスの原則とゲージのレシピに従って選ばれます。語彙を作るために用意されたテキストの中で、ある並びが頻繁に現れるほど、それが固有の番号をもつ独立したトークンになる可能性は高くなります。
難点はもうひとつ残っていました。多くのツールは、まずテキストをスペースで単語に区切っていたのです。しかし、たとえば日本語のテキストはそういうつくりになっていません。2018年、GoogleのTaku KudoとJohn Richardson6は、前もって単語を切り出すことなく、テキストそのものから分割のしかたを学ぶSentencePieceを発表しました。BPEは、そこでサポートされる方式のひとつになりました。最終的にはどれもトークンを出力するとしても、同じ課題はさまざまなアルゴリズムで解けるのです。
2019年、OpenAIはGPT-27で、文字ではなくUTF-8のバイトを結合するようになりました。バイトは256種類しかないので、語彙はどの言語のどんなテキストでも確実にカバーできます。ただし、元の記録の長さは言語によって違います。英語の文字は1バイトから、ロシア語の文字は2バイトから、漢字の多くは3バイトから出発します。最終的にトークンがいくつになるかは、この長さと、学習された結合の両方で決まります。
例のフレーズと、語彙o200k_baseで試してみましょう。
"Which camera should I buy for a blog?"
       ↓
[ 34405, 9427, 1757, 357, 3877, 395, 261, 4109, 30 ]
「 for」という断片は、単語の前のスペースも含めて、ここではまとまったひとつのトークン、395番です。「 camera」という断片にも自分の番号、9427があります。一方、語彙に丸ごとは載っていない単語、たとえば新しいブランドの名前は、いくつかの部品から組み立てられることがあります。
これはtiktokenizer.vercel.app8で見ることができます。貼り付けたテキストがどれも色とりどりの断片に砕けていき、1分もあれば仕組み全体が目に見えるようになります。トークナイザーを最後のネジ一本まで分解したいなら、カルパシー(Andrej Karpathy)と一緒にやってみてください。彼は「Let’s build the GPT Tokenizer」9で、2時間かけてゼロからトークナイザーを組み立てています。
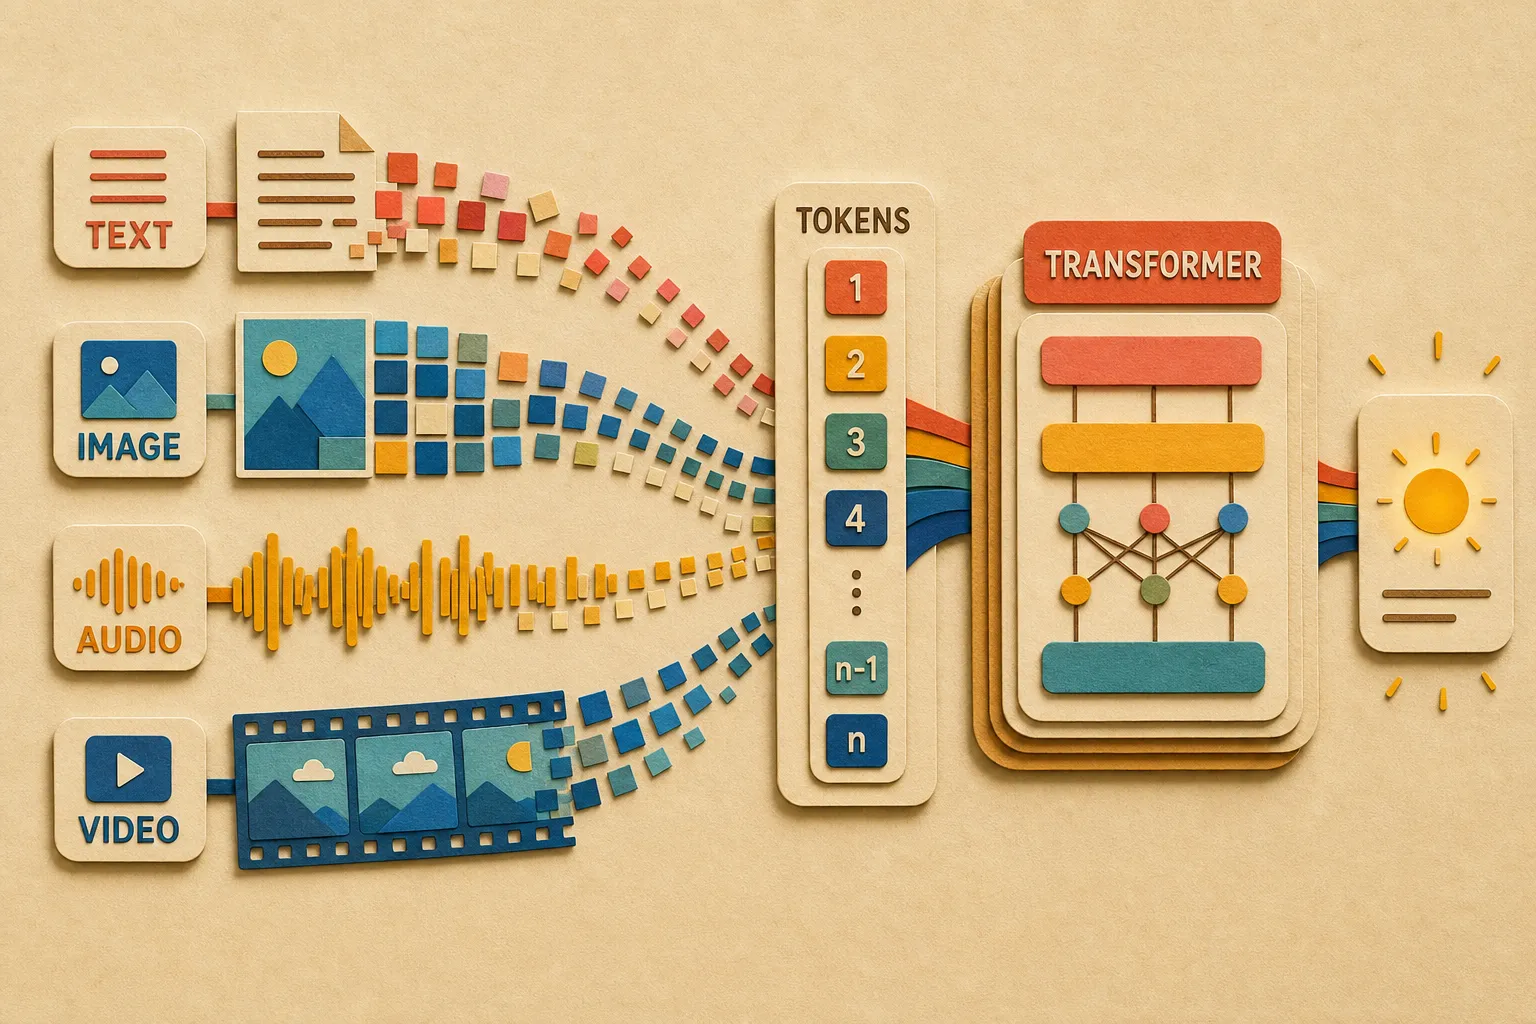
トークンという取り決めは、テキストだけにとどまりませんでした。Transformerは、並びを扱うタイプのニューラルネットワークです。画像は、まずそうした並びに変換しなければなりません。2020年、Googleのドソヴィツキー(Dosovitskiy)ら10が、「An Image is Worth 16×16 Words」という、名前がすべてを物語る論文で解決策を示しました。画像を、たとえば16×16ピクセルの正方形に切り分け、それぞれの正方形が数の組を受け取って、Transformerに入っていくのです。画像も数値表現の並びとして扱えますが、テキストの分割ルールがそのまま画像に当てはまるわけではありません。
1977  レンペルとジヴ:      よく現れる並びを辞書に入れる
1991  ベッカー、Unicode:   あらゆる文字体系をひとつの表に
1992  トンプソンとパイク:  UTF-8。文字の番号をバイトで書き表す
1994  ゲージ:              BPE。最頻ペアの結合による圧縮
2016  ゼンリッヒ:          BPEがニューラルネットワークへ。ボードやビーマーのような
                            番号の表を、モールスのように頻度で組み立てる
2018  Kudo、Richardson:    SentencePieceは単語への区切りなしに分割を学ぶ
2019  GPT-2:               UTF-8のバイトを結合し、語彙があらゆる言語をカバーする
2020  ドソヴィツキー:      画像も正方形に切り分けられ、トークンになる
出典
-
Ziv, Lempel, “A Universal Algorithm for Sequential Data Compression” (LZ77), 1977. 辞書式圧縮であり、ZIPの祖先。Wikipedia。 — https://en.wikipedia.org/wiki/LZ77_and_LZ78 ↩
-
Unicode。あらゆる文字体系のための共通の文字コード表。1988年にJoe Beckerが提案し、最初のバージョンは1991年に登場した。Wikipedia。 — https://en.wikipedia.org/wiki/Unicode ↩
-
Rob Pike, “UTF-8 history,” 2003. 1992年9月、Ken ThompsonとRob Pikeがダイナーでの夕食中にUTF-8を考案した経緯。 — https://www.cl.cam.ac.uk/~mgk25/ucs/utf-8-history.txt ↩
-
Philip Gage, “A New Algorithm for Data Compression,” 1994. オリジナルのバイト対符号化(byte pair encoding)。Wikipedia — https://en.wikipedia.org/wiki/Byte_pair_encoding ;原論文(PDF) — https://www.derczynski.com/papers/archive/BPE_Gage.pdf ↩
-
Sennrich, Haddow, Birch, “Neural Machine Translation of Rare Words with Subword Units,” 2015 (ACL 2016). BPEのアルゴリズムを言語モデルに持ち込んだ論文。 — https://arxiv.org/abs/1508.07909 ↩
-
Kudo, Richardson, “SentencePiece,” 2018. 前もって単語に区切ることなく、テキストそのものから分割のしかたを学ぶ。 — https://arxiv.org/abs/1808.06226 ↩
-
Radford et al., “Language Models are Unsupervised Multitask Learners” (GPT-2), 2019. UTF-8のバイト上で行うBPE。語彙があらゆる言語をカバーする。 — https://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf ↩
-
Tiktokenizer。インタラクティブな実験場。テキストを貼り付けるとトークンが見える。 — https://tiktokenizer.vercel.app/ ;OpenAIのtiktokenライブラリ — https://github.com/openai/tiktoken ↩
-
Andrej Karpathy, “Let’s build the GPT Tokenizer.” GPTのトークナイザーをゼロから組み立てる。 — https://www.youtube.com/watch?v=zduSFxRajkE ;動画のコード(minbpe) — https://github.com/karpathy/minbpe ↩
-
Dosovitskiy et al., “An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale,” 2020. 画像を正方形のトークンの並びとして扱う。 — https://arxiv.org/abs/2010.11929 ↩