トークンは、今も便利な勘定の単位です。コンテキストウィンドウは使える単位の数で表され、モデルを呼び出す料金は入力と出力の100万トークンあたりで計算されることが多く、生成速度は1秒あたりのトークン数で測られます。しかし、この通貨には決まった額面がありません。同じ1トークンでも、システムによって収まるテキストの量が違います。トークン数だけで速度を比べるのは、フォントの大きさを見ないまま、ページ数で読書の速さを比べるようなものです。
特定のバージョンのモデルでは、語彙と分割のルールはふつう固定されています。会社についての新しい記事が出ても、その名前が自動的に語彙に加わるわけではありません。しかしモデルは、すでにある部品からその名前を組み立てることができます。名前に固有の番号がないからといって、それを扱えなくなるわけではありません。学校の単語帳に載っていない単語でも、知っている文字で書けるのと同じです。
分割のされ方は、トークナイザーの準備に使われたデータ、その仕組み、そして言語そのものによって変わります。多言語トークナイザーの研究1では、同じ意味でも、言語によって必要なトークン数が大きく違いました。トークン単位で支払う場合、これは費用の差2にもなり、「トークン税」と呼ばれています。メッセージの意味は同じなのに、コンテキストウィンドウはより多く消費され、請求額も高くなるかもしれません。
GPT-4oが使う語彙o200k_baseで、例のフレーズを三つの言語で見てみましょう。ここから先の測定は、先頭と末尾にスペースを加えない文字列に対して、tiktokenライブラリ0.14.0で行ったものです。
Which camera should I buy for a blog?    37文字    37バイト     9トークン
Какую камеру купить для блога?           30文字    55バイト     9トークン
ブログ用にどのカメラを買うべきですか?       19文字    57バイト    16トークン
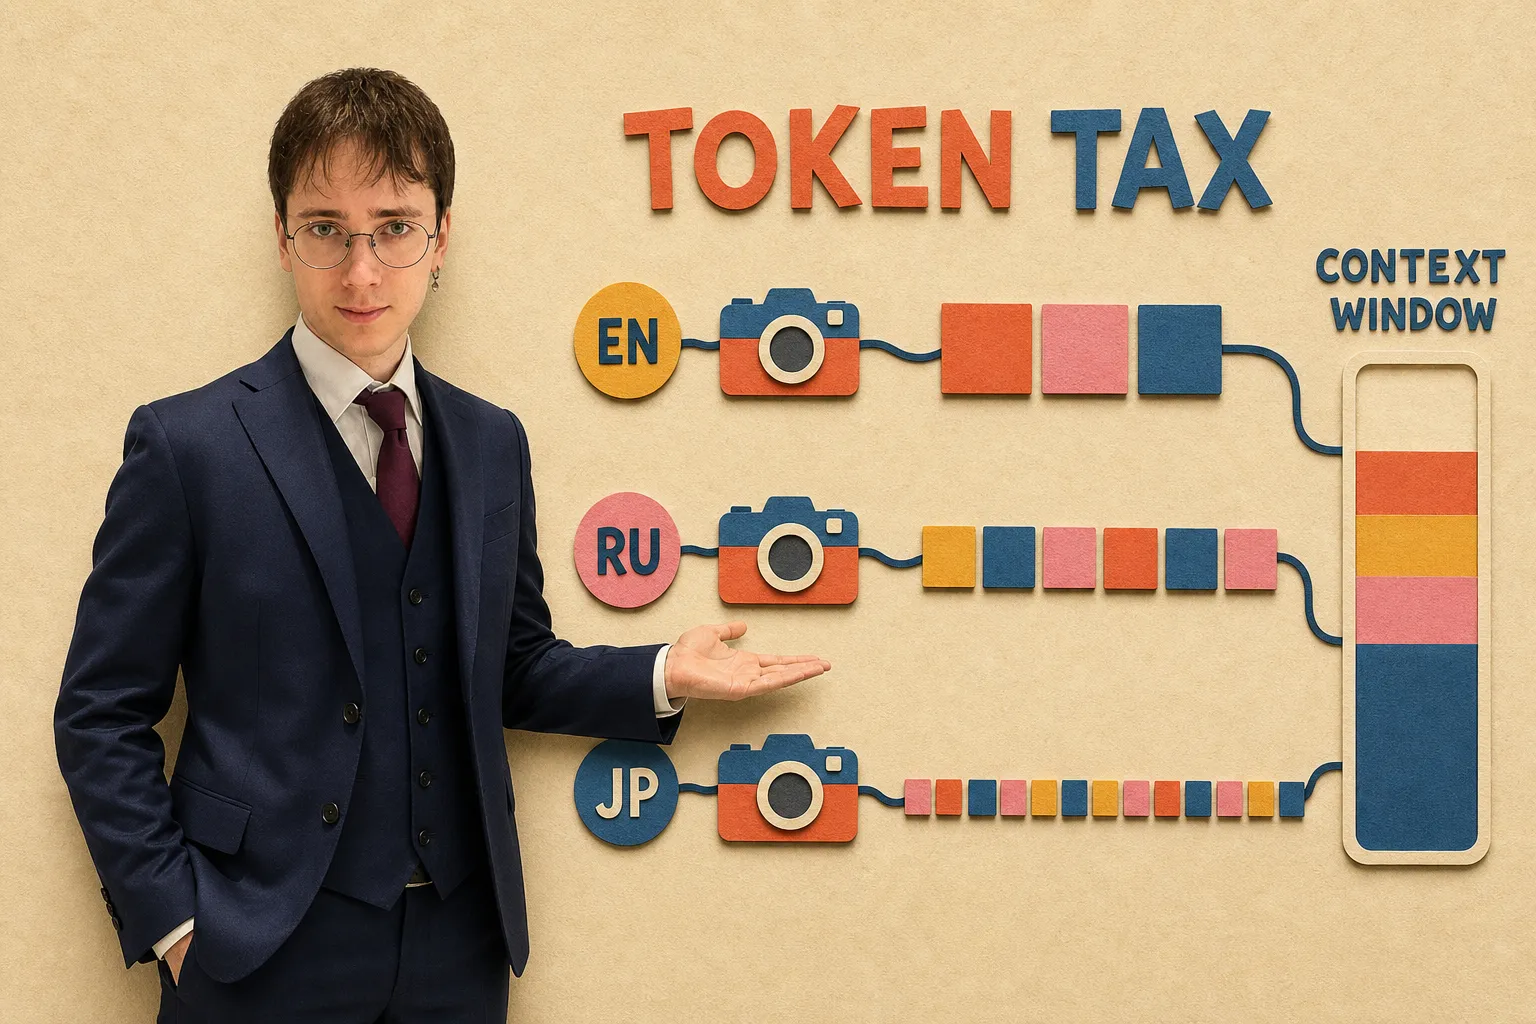
ここでロシア語のフレーズは、バイト数は多いのに、トークン数では英語と並んでいます。日本語は、目に見える文字は少ないのに、より多くのトークンを使っています。これは特定の測定の結果であって、言語間の固定の為替レートではありません。別のテキストや語彙なら、違う比率になるかもしれません。
バイトに移っても、長さが等しくなるわけではありません。英語のフレーズの37バイトも、日本語の57バイトも、どこにも消えません。前もって組み立てた単語の部品の語彙の影響は取り除かれますが、エンコーディングの特徴や、表現そのものの長さの違いは残ります。違いをすべてBPEのせいにしないためには、こうした原因を区別しておくと役に立ちます。
私たちはテキストを番号に変えました。34405、9427……。あるいは、バイトの並びのまま残しました。番号はそれだけでは、まだ何も説明しません。9427は9426より「大きい」わけでも「優れている」わけでもなく、語彙の中の行番号です。モールスも、圧縮ツールも、BPEも、バイトモデルも、計算のために記録をどう用意するかは説明してくれます。では、これらの数のどこで意味が生まれるのでしょうか?
出典
-
Petrov et al., “Language Model Tokenizers Introduce Unfairness Between Languages,” 2023. 言語による表現の長さの違い。文字やバイトに移った場合も含む。 — https://arxiv.org/abs/2305.15425 ↩
-
Ahia et al., “Do All Languages Cost the Same? Tokenization in the Era of Commercial Language Models,” 2023. トークン化と、言語モデルの利用コストとの関係。 — https://arxiv.org/abs/2305.13707 ↩