Компьютер исполняет программы, но каждую программу пишет человек: правило за правилом, шаг за шагом. И довольно быстро выяснилось, что есть задачи, для которых все возможные правила выписать вручную просто на грани невозможного. Попробуйте сформулировать правилами, чем кошка на фотографии отличается от собаки. Или что означает фраза «какую камеру купить для блога». Никому не удалось.
Инструмент, которым эти задачи в итоге решили, называется матрицей.
Сами матрицы придумали задолго до всякого AI. Это инструмент из раздела математики под названием линейная алгебра: алгебру матриц описал Артур Кэли ещё в 1858 году1, за сто лет до первых нейросетей. Тогда это была чистая игра ума, абстракция без применения. Потом матрицами описали квантовую механику, потом компьютерную графику, а теперь и интеллект. С математикой так бывает постоянно: инструмент появляется задолго до задачи, для которой он окажется главным.
Вообще матрица это просто упорядоченный набор чисел, который можно представить таблицей. Например, такой:
M = [ 2.0  0.5 ]
    [ 0.6  1.8 ]
При этом в разговорах про AI вы часто можете услышать слово «вектор». Так вот, вектор это тоже матрица, просто всего с одной строкой или одним столбцом, в зависимости от того, как записать её в конкретной формуле, ориентация задана жёстко и влияет на результат операции. Например, вот одновременно и матрица 1×2, и просто вектор из двух значений:
V = [ 1.0 -0.2 ]
Мостик от матриц к интеллекту перекинули в 1943 году, и начался он не с математики, а с биологии. Нервная клетка мозга, нейрон, работает примерно так: к ней тянутся отростки от тысяч соседних клеток, и по каждому приходит сигнал. Связи при этом неравноценны: одни сильные, сигнал по ним доходит «громко», другие слабые, еле слышные. Клетка собирает всё пришедшее вместе, и если суммарного сигнала набралось достаточно, она «вспыхивает» и посылает сигнал дальше, уже своим соседям.
Маккалок и Питтс2 записали это поведение числами, и получился математический нейрон, простейшая модель нервной клетки. Сигнал от каждого соседа это вход, просто число. Сила связи это вес, ещё одно число. Каждый вход умножается на свой вес, произведения складываются, сумма сравнивается с порогом: дотянула – нейрон выдаёт сигнал.
входы:  x₁, x₂, x₃          сигналы от соседей
веса:   w₁, w₂, w₃          сила каждой связи

x₁·w₁ + x₂·w₂ + x₃·w₃  ≥  порог   →   нейрон «вспыхивает»
Вся работа нервной клетки свелась к одному действию: «перемножить и сложить». А вдохновлялись Маккалок и Питтс той же булевой логикой: в их статье прямо показано, как из таких нейронов собираются те самые три ключевые операции AND, OR и NOT.
При чём же здесь матрицы? Присмотритесь к умножению вектора на матрицу: чтобы получить каждое число результата, надо перемножить ряд чисел и сложить произведения. Это буквально та же операция, что делает нейрон. Один нейрон – одно «перемножить и сложить». А нейроны работают не поодиночке, а слоями: несколько нейронов смотрят на одни и те же входы, но у каждого свои веса. Запишем входы вектором V, а веса всех нейронов слоя – матрицей M, по столбцу на нейрон. Тогда весь слой считается одним умножением V × M, и на выходе получается новый вектор V': по числу от каждого нейрона. Сама операция простейшая, её проходят в школах во многих странах, и она ненамного сложнее, чем перемножить два числа.
V × M = [ 1.0  -0.2 ] × [ 2.0  0.5 ]  =  [ 1.88  0.14 ] = V'
                        [ 0.6  1.8 ]

первый нейрон, его веса 2.0 и 0.6:   1.0·2.0 + (-0.2)·0.6  =  1.88
второй нейрон, его веса 0.5 и 1.8:   1.0·0.5 + (-0.2)·1.8  =  0.14
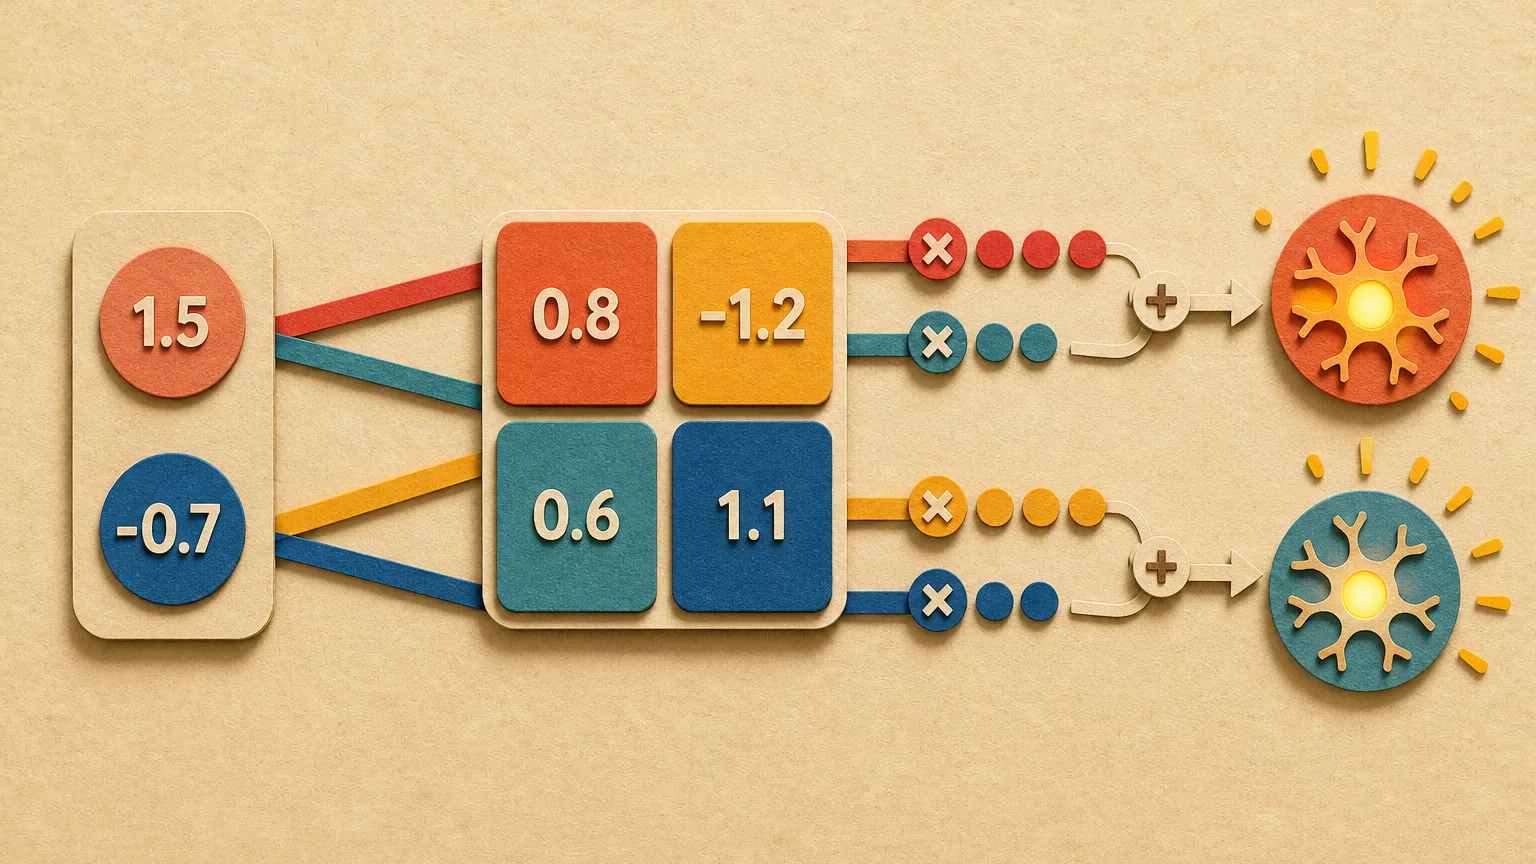
Именно на этой операции в своей основе и работают все современные нейросети, включая ChatGPT, Claude и Gemini.
Мечту о машине, которая сама справляется с задачами, для которых правила не выписать, назвали искусственным интеллектом: термин AI предложил Джон Маккарти в 1955 году3. Подходов к этой мечте перепробовали много, а победил в итоге один: machine learning, машинное обучение. Его идея переворачивает программирование наоборот: не человек пишет правила, а машина сама выучивает их из примеров.
Главный инструмент этого подхода сегодня – нейросети. А нейросеть, выученная на текстах, называется LLM (Large Language Model, большая языковая модель). ChatGPT, Claude, Gemini и остальные герои этой книги построены именно вокруг LLM.
AI         мечта: машина решает задачи, для которых правила не выписать
 ML        способ: правила не пишутся человеком, а выучиваются из примеров
  Нейросети    инструмент: слои из «перемножить и сложить»
   LLM         нейросеть, выученная на текстах   ←   про неё вся книга
И ровно как компьютеры это “просто” нули и единицы, с операциями и договорённостями, так и нейросети под капотом это “просто” наборы чисел, организованные в так называемые матрицы, над которыми можно делать математические операции, и на выходе снова получать матрицы! И поверх – наши договорённости о том, что всё это значит.
В 1958 году Розенблатт4 превратил математический нейрон в реальное железо. Его машина называлась перцептрон, и внутри неё была всё та же знакомая нам операция «перемножить и сложить»: входы умножаются на веса, произведения складываются, сумма сравнивается с порогом. Дотянула до порога – машина отвечает «да», не дотянула – «нет».
Новым было другое: перцептрон первым в истории учился на примерах. Устроена учёба просто. Машине показывают пример, она отвечает, ответ сверяют с правильным:
ответ совпал с правильным  →  веса не трогаем
ответ ошибочный            →  каждый вес чуть сдвигаем
                              в сторону правильного ответа
И так тысячи раз, пример за примером. Никто не писал правил – веса настроились сами. Это был фурор: газеты обещали машины, которые скоро будут ходить, говорить и осознавать себя, военные выделяли финансирование. Казалось, до думающей машины рукой подать.
Но в 1969 году Минский и Пейперт5 строго доказали: одной операции «перемножить и сложить» хватает только на самые простые задачи. Дело вот в чём. Ответ перцептрона всегда устроен одинаково: чем больше сумма, тем ближе к «да». А есть задачи, где правильный ответ устроен иначе. Например: два входа, и «да» полагается, только когда включён ровно один из них.
включён только A   →   сумма дотянула до порога   →   «да»    верно
включён только B   →   сумма дотянула до порога   →   «да»    верно
включены A и B     →   сумма стала ещё больше     →   «да»    а нужно «нет»!
Второй вход может только увеличить сумму, повернуть её назад нечем. И сколько ни двигай веса, это не исправить: проблема не в весах, а в самой операции. «Перемножить и сложить» это один шаг, а бывают задачи, которые в один шаг не решаются. Обещали думающую машину – а она споткнулась на задачке с двумя входами. Энтузиазм рухнул, финансирование за ним, и наступила «зима искусственного интеллекта».
Кэли:               матрица – таблица чисел, придуманная за век до нейросетей
                       ↓
Маккалок и Питтс:   нейрон это «перемножить и сложить» с порогом,
                    а слой нейронов – умножение на матрицу
                       ↓
Маккарти:           мечту о машине, решающей такие задачи, назвали AI
                       ↓
Розенблатт:         веса можно не задавать, а выучивать на примерах
                       ↓
Минский и Пейперт:  но один слой упирается в потолок → «зима AI»
На этом история искусственного интеллекта могла бы и закончиться. К счастью, не закончилась.
Источники
-
Arthur Cayley, «A Memoir on the Theory of Matrices», 1858 – работа, задавшая алгебру матриц, за век до нейросетей. – https://en.wikisource.org/wiki/A_Memoir_on_the_Theory_of_Matrices ↩
-
McCulloch, Pitts, «A Logical Calculus of the Ideas Immanent in Nervous Activity», 1943 – первый математический нейрон, собранный из булевой логики. – https://www.cs.cmu.edu/~./epxing/Class/10715/reading/McCulloch.and.Pitts.pdf ↩
-
McCarthy, Minsky, Rochester, Shannon, «A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence», 1955 – документ, в котором впервые прозвучал термин artificial intelligence. – http://jmc.stanford.edu/articles/dartmouth/dartmouth.pdf ↩
-
Rosenblatt, «The Perceptron: A Probabilistic Model», 1958 – первая обучающаяся машина: веса подбираются по ошибкам. – https://homepages.math.uic.edu/~lreyzin/papers/rosenblatt58.pdf ↩
-
Minsky, Papert, «Perceptrons», 1969 – доказательство пределов однослойной сети, с которого началась «зима AI». – https://en.wikipedia.org/wiki/Perceptrons_(book) ↩